

قطعت برامج LLM مفتوحة المصدر مثل Falcon أو (Open-)LLaMA أو X-Gen أو StarCoder أو RedPajama شوطًا طويلًا في الأشهر الأخيرة ويمكنها التنافس مع نماذج مغلقة المصدر مثل ChatGPT أو GPT4 في حالات استخدام معينة. ومع ذلك، فإن نشر هذه النماذج بطريقة فعالة ومُحسّنة لا يزال يمثل تحديًا.
في منشور المدونة هذا، سنوضح لك كيفية نشر LLMs مفتوحة المصدر في Hugging Face Inference Endpoints، وهو حل SaaS المُدار لدينا والذي يجعل من السهل نشر النماذج. بالإضافة إلى ذلك، سنعلمك كيفية بث الاستجابات واختبار أداء نقاط النهاية لدينا. لذلك دعونا نبدأ!
- كيفية نشر تعليمات Falcon 40B
- اختبار نقطة النهاية LLM
- دفق الاستجابات في Javascript وPython
قبل أن نبدأ، دعونا نقوم بتحديث معرفتنا حول نقاط نهاية الاستدلال.
ما هو معانقة نقاط النهاية استنتاج الوجه
توفر Hugging Face Inference Endpoints طريقة سهلة وآمنة لنشر نماذج التعلم الآلي لاستخدامها في الإنتاج. تعمل نقاط نهاية الاستدلال على تمكين المطورين وعلماء البيانات على حد سواء من إنشاء تطبيقات الذكاء الاصطناعي دون إدارة البنية التحتية: مما يؤدي إلى تبسيط عملية النشر ببضع نقرات، بما في ذلك التعامل مع كميات كبيرة من الطلبات من خلال التوسع التلقائي، وتقليل تكاليف البنية التحتية من خلال التوسع إلى الصفر، وتوفير أمان متقدم.
فيما يلي بعض أهم الميزات لنشر LLM:
- النشر السهل: انشر النماذج كواجهات برمجة تطبيقات جاهزة للإنتاج ببضع نقرات فقط، مما يلغي الحاجة إلى التعامل مع البنية التحتية أو عمليات MLOs.
- كفاءة التكلفة: الاستفادة من النطاق التلقائي إلى القدرة الصفرية، مما يقلل التكاليف عن طريق تقليص البنية التحتية عندما لا تكون نقطة النهاية قيد الاستخدام، مع الدفع على أساس وقت تشغيل نقطة النهاية، مما يضمن فعالية التكلفة.
- أمان المؤسسة: انشر النماذج في نقاط نهاية آمنة غير متصلة بالإنترنت ولا يمكن الوصول إليها إلا من خلال اتصالات VPC المباشرة، المدعومة بشهادة SOC2 Type 2، وتقديم اتفاقيات معالجة البيانات BAA وGDPR لتحسين أمان البيانات والامتثال.
- تحسين LLM: مُحسّن لـ LLMs، مما يتيح إنتاجية عالية مع Paged Attention وزمن وصول منخفض من خلال رمز المحولات المخصص وقوة Flash Attention من خلال استدلال إنشاء النص
- دعم شامل للمهام: دعم خارج الصندوق لمهام ونماذج المحولات ومحولات الجملة والناشرين، والتخصيص السهل لتمكين المهام المتقدمة مثل مذكرات المتحدث أو أي مهمة ومكتبة للتعلم الآلي.
يمكنك البدء باستخدام Inference Endpoints على: https://ui.endpoints.huggingface.co/
1. كيفية نشر تعليمات Falcon 40B
للبدء، يجب عليك تسجيل الدخول باستخدام حساب مستخدم أو مؤسسة مع طريقة دفع مسجلة (يمكنك إضافة واحدة هنا)، ثم قم بالوصول إلى نقاط نهاية الاستدلال في https://ui.endpoints.huggingface.co
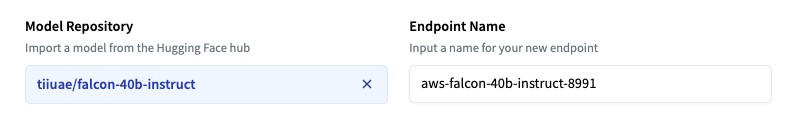
ثم انقر على “نقطة النهاية الجديدة”. حدد المستودع والسحابة والمنطقة، واضبط إعدادات المثيل والأمان، ثم قم بالنشر في حالتنا tiiuae/falcon-40b-instruct.
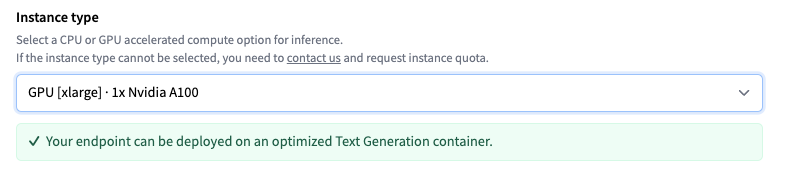
تقترح نقاط نهاية الاستدلال نوع مثيل بناءً على حجم النموذج، والذي يجب أن يكون كبيرًا بما يكفي لتشغيل النموذج. هنا 4x NVIDIA T4 وحدات معالجة الرسومات. للحصول على أفضل أداء لـ LLM، قم بتغيير المثيل إلى GPU [xlarge] · 1x Nvidia A100.
ملاحظة: إذا تعذر تحديد نوع المثيل، فستحتاج إلى الاتصال بنا وطلب حصة المثيل.
يمكنك بعد ذلك نشر النموذج الخاص بك بالنقر فوق “إنشاء نقطة نهاية”. وبعد 10 دقائق، يجب أن تكون نقطة النهاية متصلة بالإنترنت ومتاحة لخدمة الطلبات.
2. اختبر نقطة نهاية LLM
توفر النظرة العامة على نقطة النهاية إمكانية الوصول إلى أداة الاستدلال، والتي يمكن استخدامها لإرسال الطلبات يدويًا. يتيح لك ذلك اختبار نقطة النهاية الخاصة بك بسرعة باستخدام مدخلات مختلفة ومشاركتها مع أعضاء الفريق. لا تدعم هذه الأدوات المعلمات – وفي هذه الحالة يؤدي ذلك إلى جيل “قصير”.
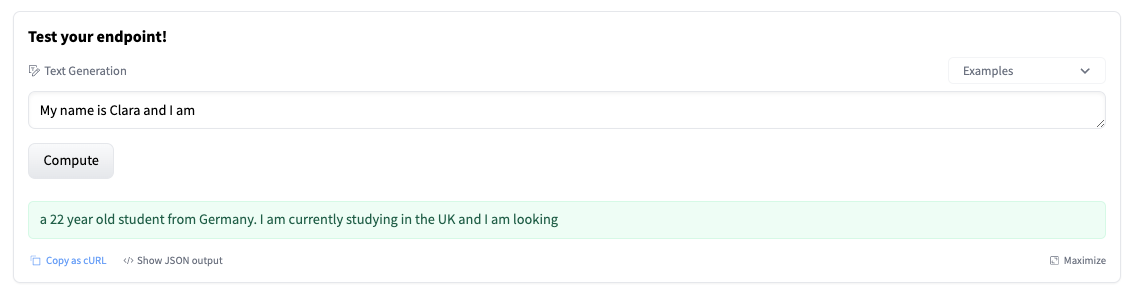
تقوم الأداة أيضًا بإنشاء أمر cURL الذي يمكنك استخدامه. فقط أضف الخاص بك hf_xxx والاختبار.
curl https://j4xhm53fxl9ussm8.us-east-1.aws.endpoints.huggingface.cloud \
-X POST \
-d '"inputs":"Once upon a time,"' \
-H "Authorization: Bearer <hf_token>" \
-H "Content-Type: application/json"
يمكنك استخدام معلمات مختلفة للتحكم في التوليد، وتحديدها في ملف parameters سمة الحمولة. اعتبارًا من اليوم، يتم دعم المعلمات التالية:
temperature: يتحكم في العشوائية في النموذج. القيم المنخفضة ستجعل النموذج أكثر حتمية والقيم الأعلى ستجعل النموذج أكثر عشوائية. القيمة الافتراضية هي 1.0.max_new_tokens: الحد الأقصى لعدد الرموز التي سيتم إنشاؤها. القيمة الافتراضية هي 20، والقيمة القصوى هي 512.repetition_penalty: يتحكم في احتمالية التكرار. الافتراضي هوnull.seed: البذور لاستخدامها في توليد عشوائي. الافتراضي هوnull.stop: قائمة الرموز لوقف التوليد. سيتوقف الجيل عند إنشاء أحد الرموز المميزة.top_k: عدد رموز المفردات ذات الاحتمالية الأعلى التي يجب الاحتفاظ بها لتصفية top-k. القيمة الافتراضية هيnull، مما يؤدي إلى تعطيل تصفية top-k.top_p: الاحتمال التراكمي للمعلمة أعلى رموز المفردات احتمالية للاحتفاظ بها لأخذ عينات النواة، الافتراضي هوnulldo_sample: ما إذا كان سيتم استخدام أخذ العينات أم لا؛ استخدام فك الجشع خلاف ذلك. القيمة الافتراضية هيfalse.best_of: قم بإنشاء تسلسلات best_of وإرجاع التسلسل إذا كان أعلى رمز مميز، افتراضيًاnull.details: أم لا لإرجاع تفاصيل حول الجيل. القيمة الافتراضية هيfalse.return_full_text: ما إذا كان سيتم إرجاع النص الكامل أم لا فقط الجزء الذي تم إنشاؤه. القيمة الافتراضية هيfalse.truncate: ما إذا كان سيتم اقتطاع الإدخال إلى الحد الأقصى لطول النموذج أم لا. القيمة الافتراضية هيtrue.typical_p: الاحتمال النموذجي للرمز المميز. القيمة الافتراضية هيnull.watermark: العلامة المائية المستخدمة للتوليد. القيمة الافتراضية هيfalse.
3. دفق الاستجابات في Javascript وPython
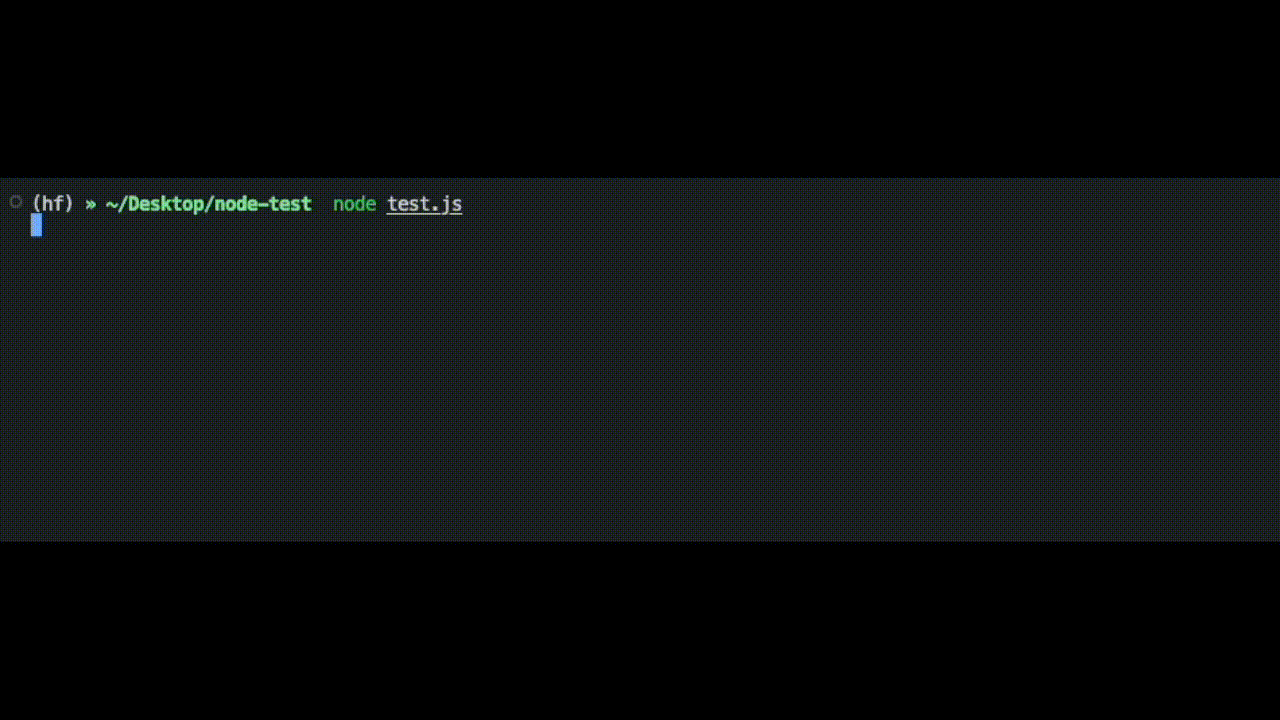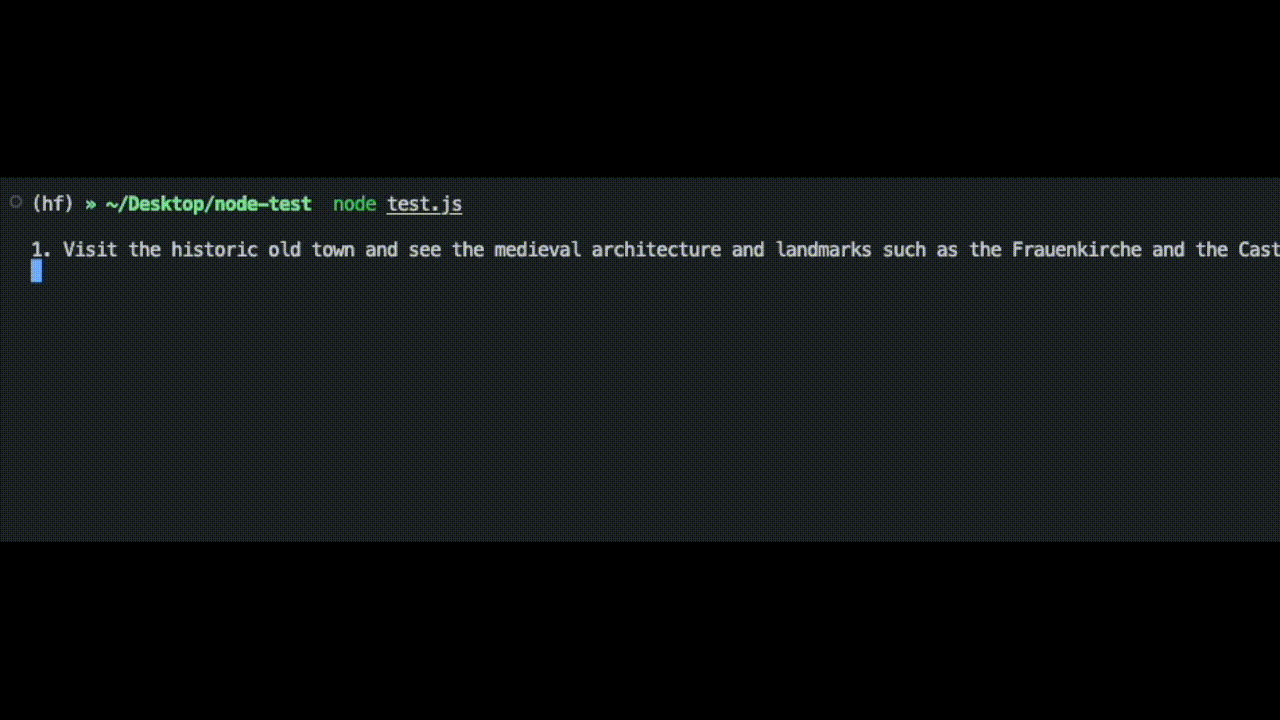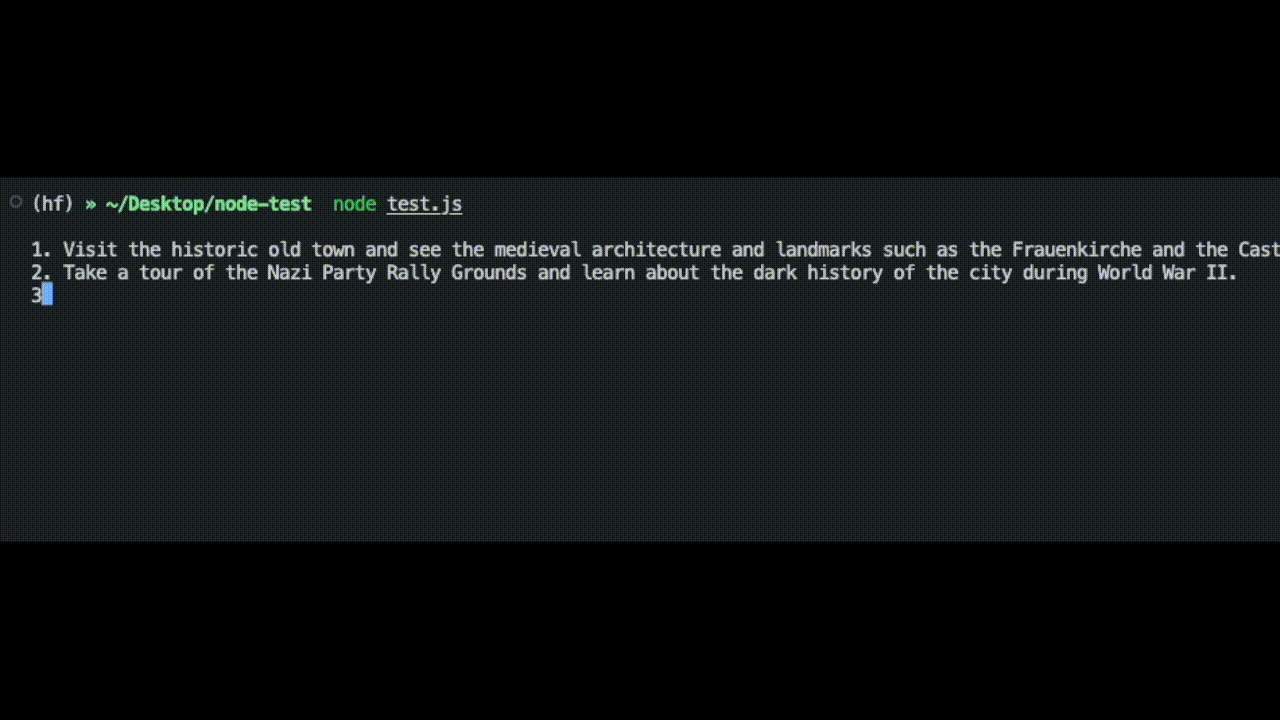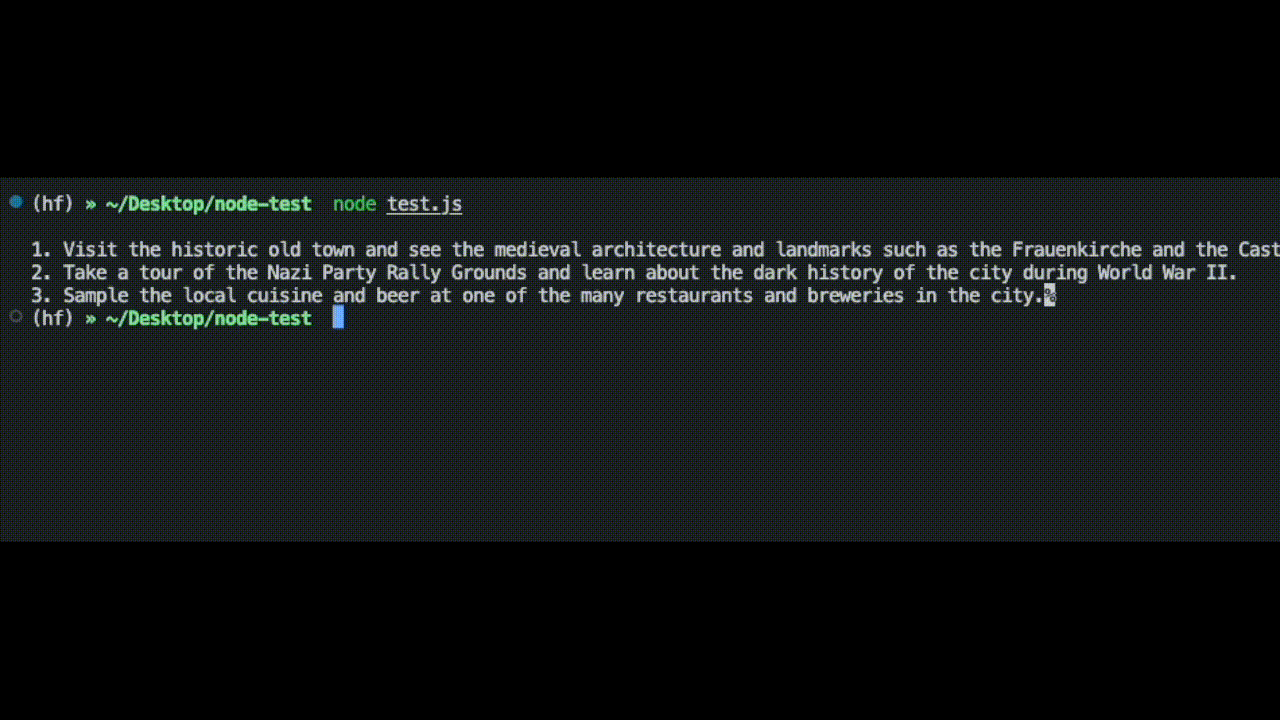
يمكن أن يكون طلب وإنشاء النص باستخدام LLMs عملية تستغرق وقتًا طويلاً ومتكررة. هناك طريقة رائعة لتحسين تجربة المستخدم وهي بث الرموز المميزة للمستخدم عند إنشائها. فيما يلي مثالان لكيفية دفق الرموز المميزة باستخدام Python وJavaScript. بالنسبة لـ Python، سنستخدم العميل من Text Generation Inference، وبالنسبة لـ JavaScript، سنستخدم مكتبة HuggingFace.js
طلبات الدفق مع بايثون
أولا، تحتاج إلى تثبيت huggingface_hub مكتبة:
pip install -U huggingface_hub
يمكننا إنشاء InferenceClient توفير عنوان URL لنقطة النهاية وبيانات الاعتماد الخاصة بنا جنبًا إلى جنب مع المعلمات الفائقة التي نريد استخدامها
from huggingface_hub import InferenceClient


endpoint_url = "https://YOUR_ENDPOINT.endpoints.huggingface.cloud"
hf_token = "hf_YOUR_TOKEN"


client = InferenceClient(endpoint_url, token=hf_token)


gen_kwargs = dict(
    max_new_tokens=512,
    top_k=30,
    top_p=0.9,
    temperature=0.2,
    repetition_penalty=1.02,
    stop_sequences=["\nUser:", "<|endoftext|>", "</s>"],
)

prompt = "What can you do in Nuremberg, Germany? Give me 3 Tips"

stream = client.text_generation(prompt, stream=True, details=True, **gen_kwargs)


for r in stream:

    if r.token.special:
        continue

    if r.token.text in gen_kwargs["stop_sequences"]:
        break

    print(r.token.text, end = "")
استبدل print الأمر مع yield أو مع الوظيفة التي تريد دفق الرموز المميزة إليها.
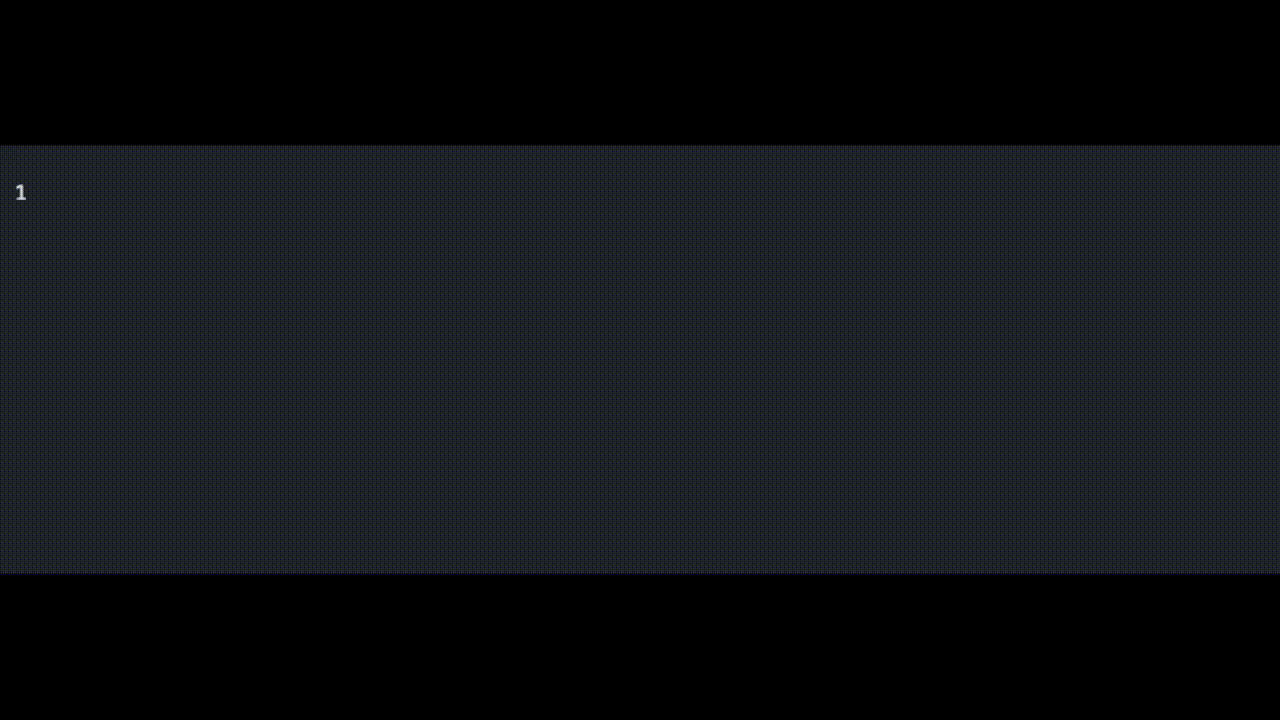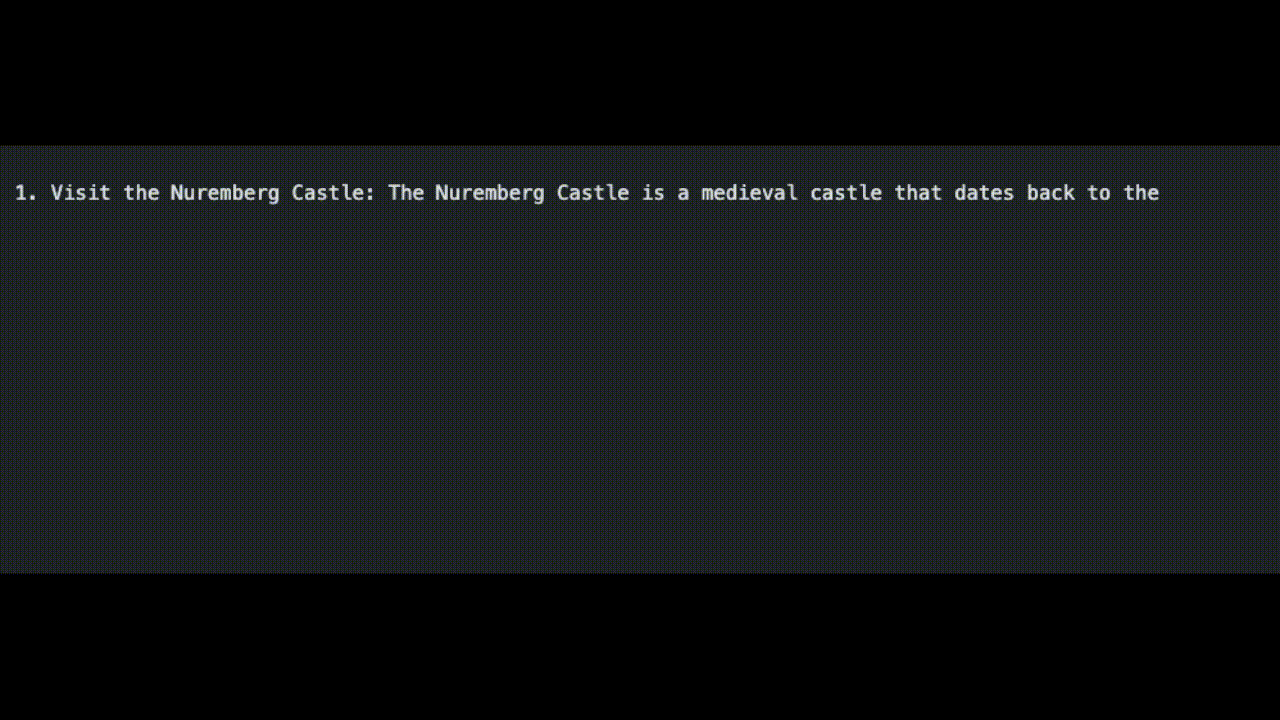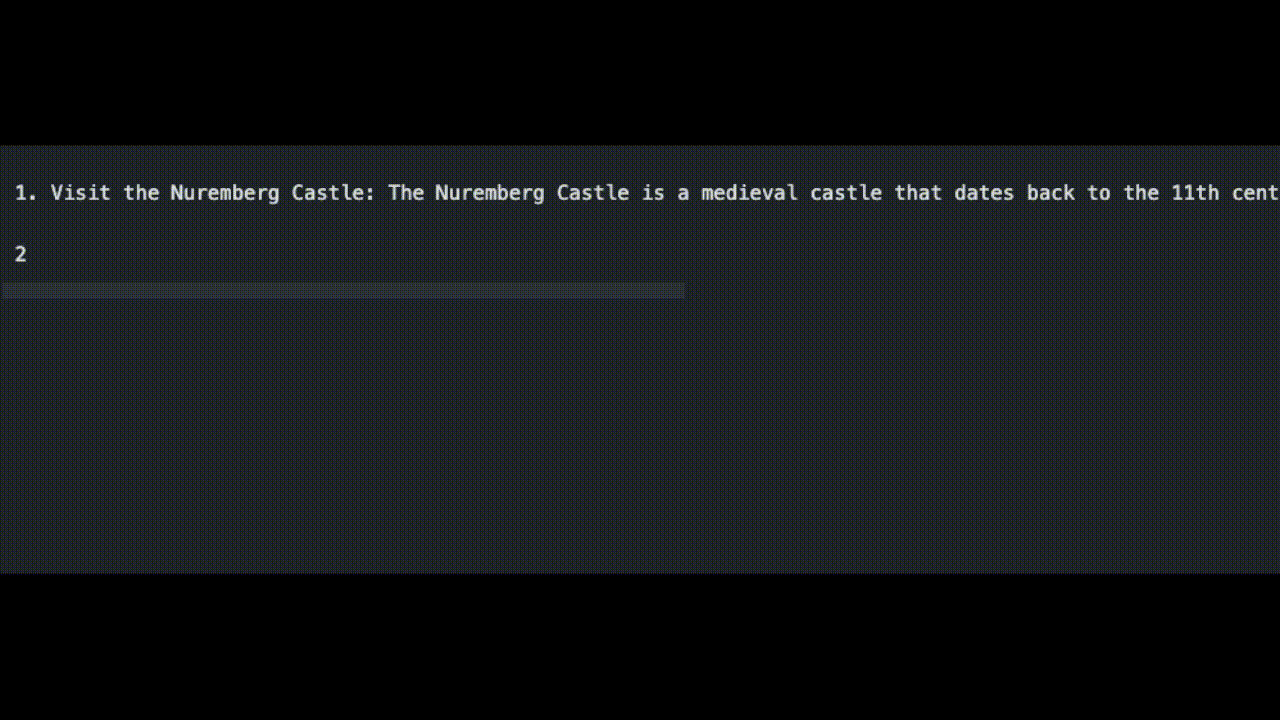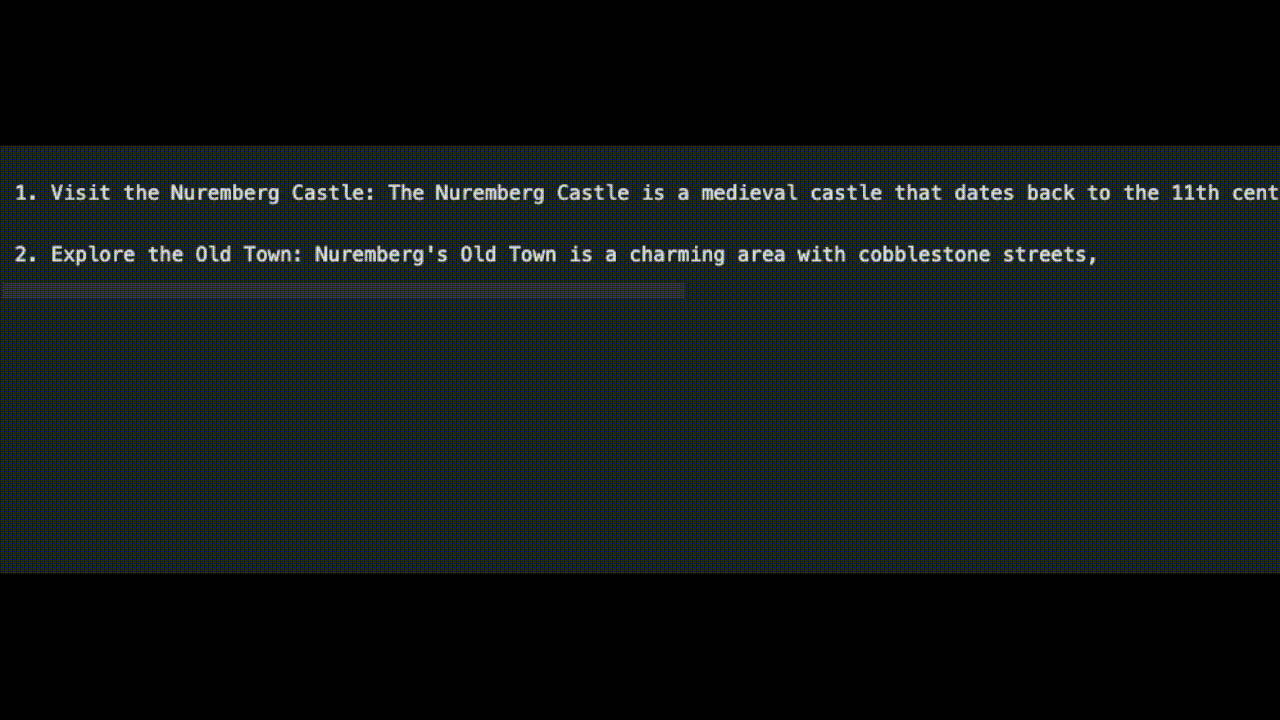
طلبات التدفق باستخدام JavaScript
أولا، تحتاج إلى تثبيت @huggingface/inference مكتبة.
npm install @huggingface/inference
يمكننا إنشاء HfInferenceEndpoint توفير عنوان URL لنقطة النهاية وبيانات الاعتماد الخاصة بنا جنبًا إلى جنب مع المعلمة الفائقة التي نريد استخدامها.
import  HfInferenceEndpoint  from '@huggingface/inference'

const hf = new HfInferenceEndpoint('https://YOUR_ENDPOINT.endpoints.huggingface.cloud', 'hf_YOUR_TOKEN')


const gen_kwargs = >', '</s>'],


const prompt = 'What can you do in Nuremberg, Germany? Give me 3 Tips'

const stream = hf.textGenerationStream( inputs: prompt, parameters: gen_kwargs )
for await (const r of stream)

  if (r.token.special)
    continue


  if (gen_kwargs['stop_sequences'].includes(r.token.text))
    break


  process.stdout.write(r.token.text)
استبدل process.stdout اتصل مع yield أو مع الوظيفة التي تريد دفق الرموز المميزة إليها.
خاتمة
في منشور المدونة هذا، أظهرنا لك كيفية نشر LLMs مفتوحة المصدر باستخدام Hugging Face Inference Endpoints، وكيفية التحكم في إنشاء النص باستخدام المعلمات المتقدمة، وكيفية بث الاستجابات إلى عميل Python أو JavaScript لتحسين تجربة المستخدم. باستخدام Hugging Face Inference Endpoints، يمكنك نشر النماذج كواجهات برمجة تطبيقات جاهزة للإنتاج ببضع نقرات فقط، وتقليل تكاليفك من خلال القياس التلقائي إلى الصفر، ونشر النماذج في نقاط نهاية آمنة غير متصلة بالإنترنت مدعومة بشهادة SOC2 Type 2.
شكرا للقراءة! إذا كان لديك أي أسئلة، فلا تتردد في الاتصال بي على تغريد أو لينكدين.
