

[Updated on July 24, 2023: Added Llama 2.]
لقد كانت تقنيات إنشاء النصوص والمحادثة موجودة منذ زمن طويل. كانت التحديات السابقة في العمل مع هذه التقنيات هي التحكم في تماسك النص وتنوعه من خلال معلمات الاستدلال والتحيزات التمييزية. كانت المخرجات الأكثر تماسكًا أقل إبداعًا وأقرب إلى بيانات التدريب الأصلية وبدت أقل إنسانية. وقد تغلبت التطورات الأخيرة على هذه التحديات، ومكنت واجهات المستخدم سهلة الاستخدام الجميع من تجربة هذه النماذج. سلطت خدمات مثل ChatGPT الضوء مؤخرًا على نماذج قوية مثل GPT-4 وتسببت في انتشار البدائل مفتوحة المصدر مثل Llama. نعتقد أن هذه التقنيات ستظل موجودة لفترة طويلة وستصبح مدمجة أكثر فأكثر في المنتجات اليومية.
هذه التدوينة مقسمة إلى الأقسام التالية:
- خلفية موجزة عن إنشاء النص
- الترخيص
- الأدوات في النظام البيئي المعانق لخدمة LLM
- الضبط الدقيق الفعال للمعلمة (PEFT)
خلفية موجزة عن إنشاء النص
يتم تدريب نماذج إنشاء النص بشكل أساسي بهدف إكمال نص غير مكتمل أو إنشاء نص من الصفر كرد على تعليمات أو سؤال معين. تسمى النماذج التي تكمل النص غير المكتمل بنماذج اللغة السببية، ومن الأمثلة الشهيرة GPT-3 بواسطة OpenAI وLlama بواسطة Meta AI.
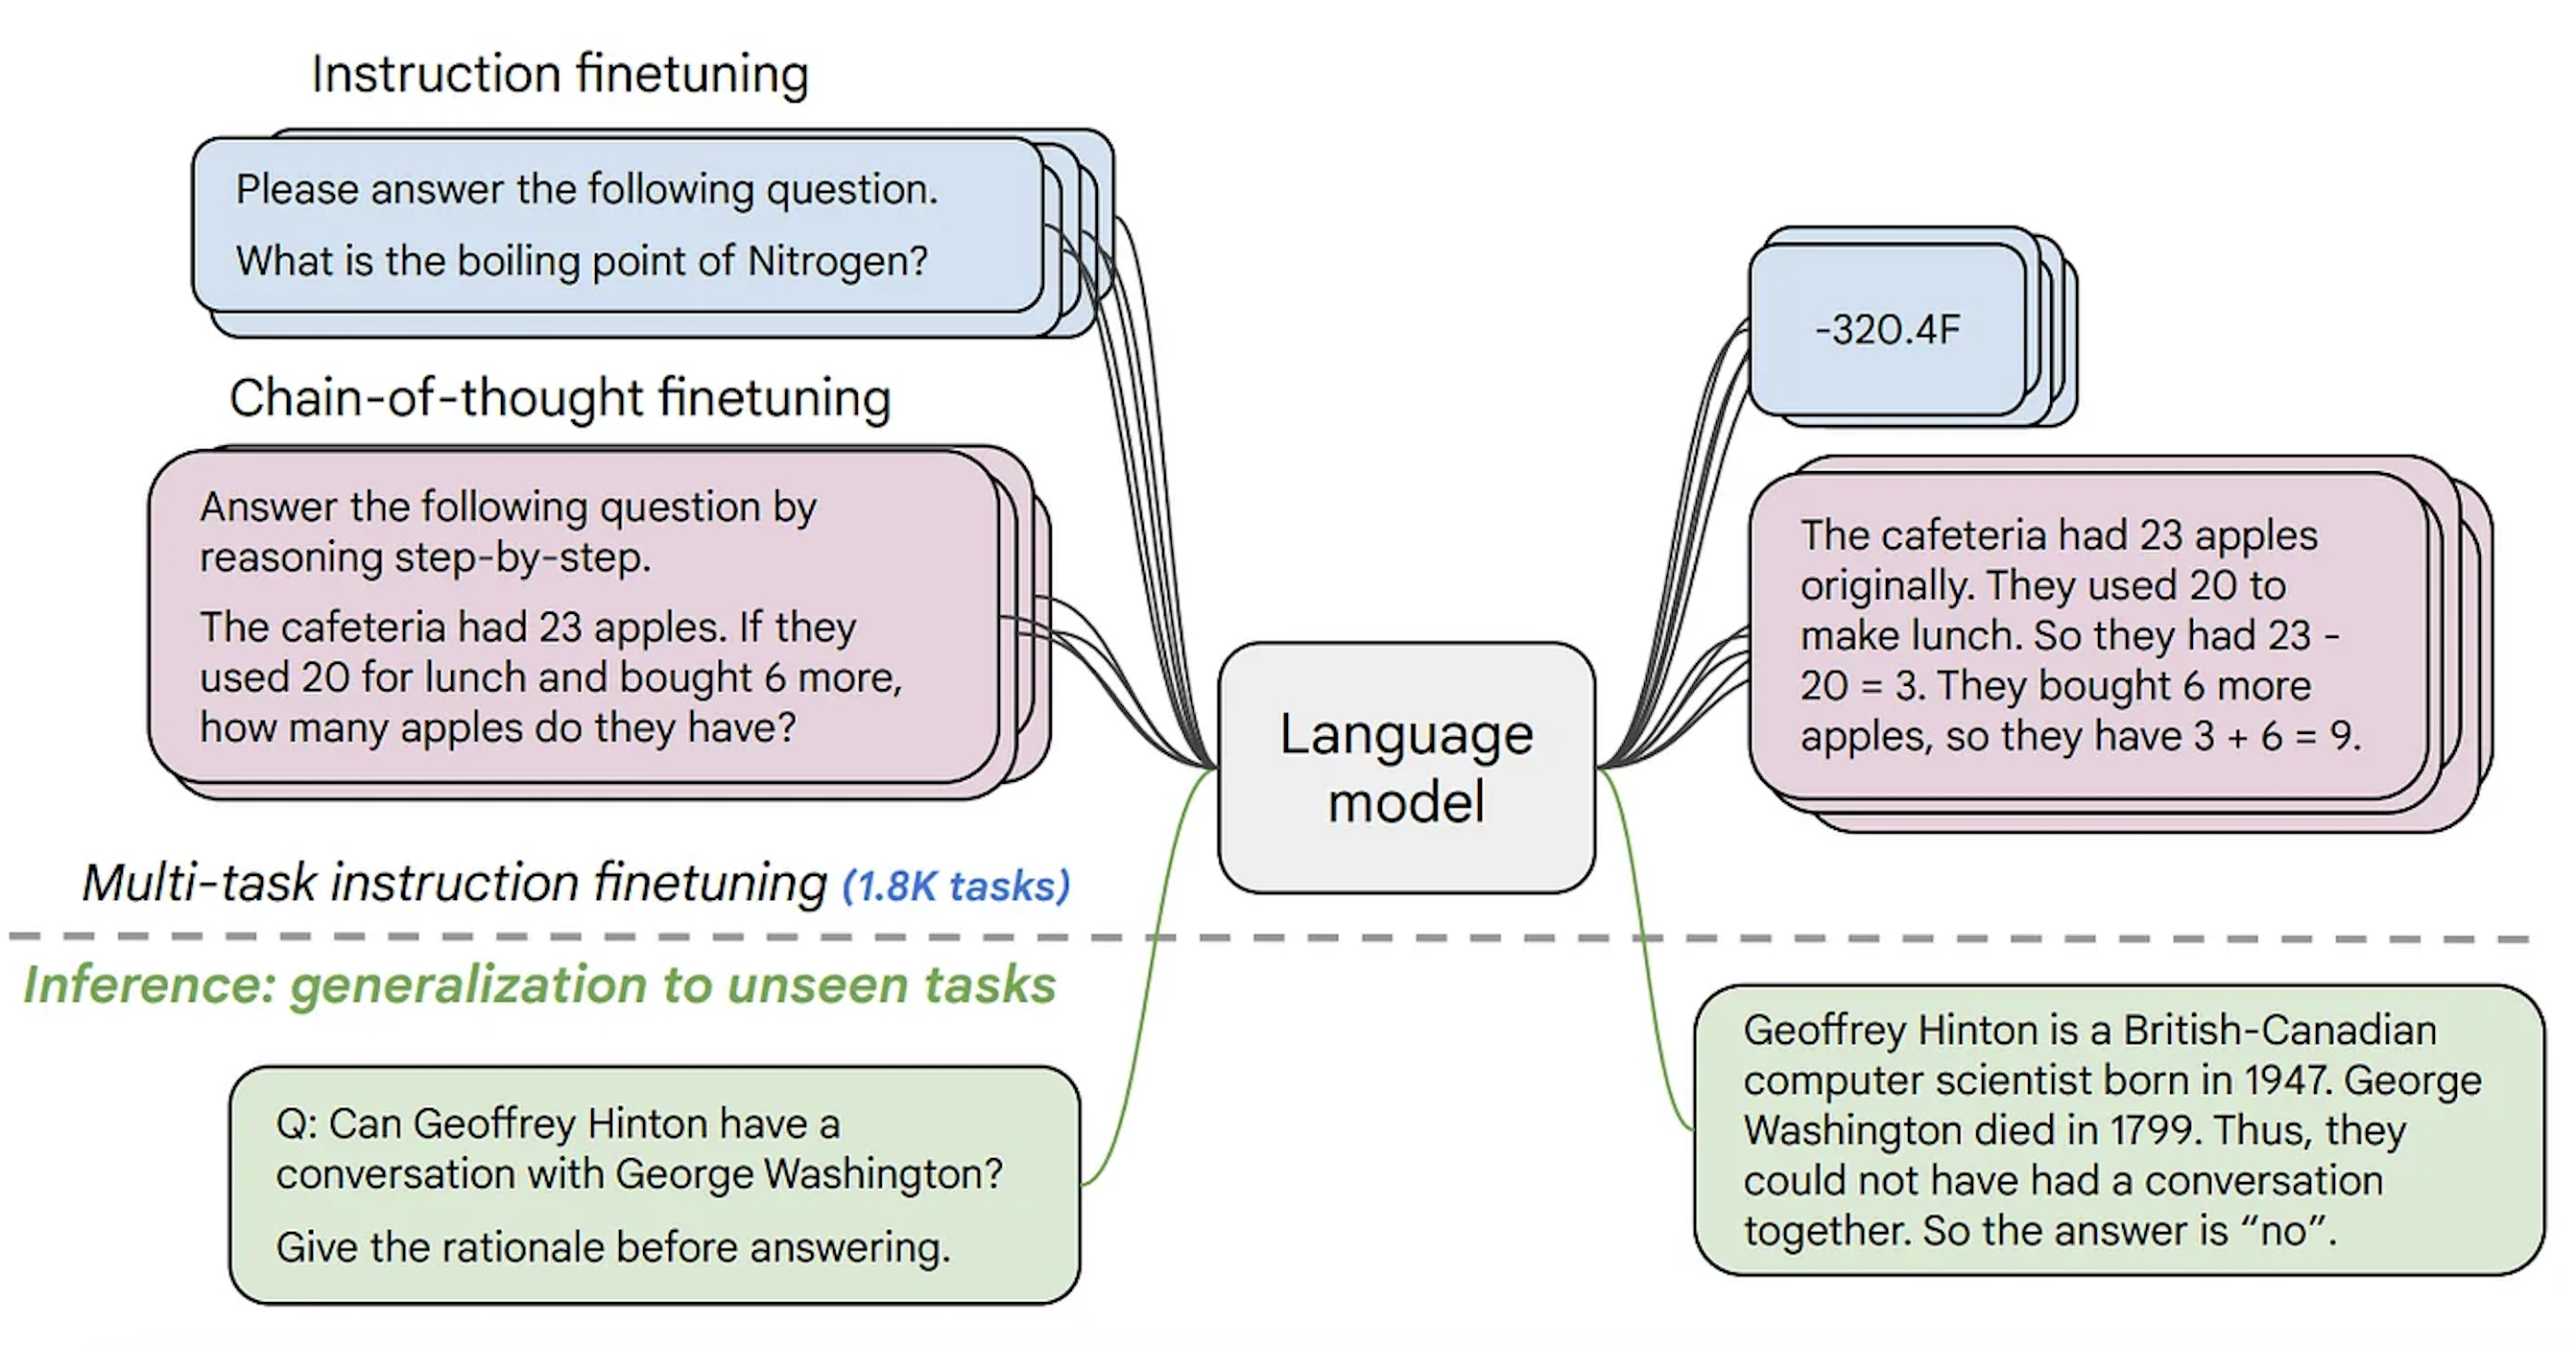
أحد المفاهيم التي تحتاج إلى معرفتها قبل المضي قدمًا هو الضبط الدقيق. هذه هي عملية أخذ نموذج كبير جدًا ونقل المعرفة الموجودة في هذا النموذج الأساسي إلى حالة استخدام أخرى، والتي نطلق عليها اسم مهمة المصب. يمكن أن تأتي هذه المهام في شكل تعليمات. مع نمو حجم النموذج، يمكن تعميمه بشكل أفضل على التعليمات غير الموجودة في بيانات ما قبل التدريب، ولكن تم تعلمها أثناء الضبط الدقيق.
يتم تكييف نماذج اللغة السببية باستخدام عملية تسمى التعلم المعزز من ردود الفعل البشرية (RLHF). يتم إجراء هذا التحسين بشكل أساسي على مدى طبيعية وتماسك النص بدلاً من صحة الإجابة. إن شرح كيفية عمل RLHF يقع خارج نطاق منشور المدونة هذا، ولكن يمكنك العثور على مزيد من المعلومات حول هذه العملية هنا.
على سبيل المثال، GPT-3 هي لغة سببية قاعدة نموذج، في حين يتم ضبط النماذج الموجودة في الواجهة الخلفية لـ ChatGPT (وهي واجهة المستخدم لنماذج سلسلة GPT) من خلال RLHF على المطالبات التي يمكن أن تتكون من محادثات أو تعليمات. من المهم التمييز بين هذه النماذج.
في Hugging Face Hub، يمكنك العثور على نماذج اللغة السببية ونماذج اللغة السببية التي تم ضبطها بدقة بناءً على التعليمات (والتي سنقدم لها روابط لاحقًا في منشور المدونة هذا). تعد Llama واحدة من أولى برامج LLM مفتوحة المصدر التي تفوقت في الأداء على البرامج مغلقة المصدر أو طابقتها. قامت مجموعة بحثية بقيادة شركة Together بإنشاء نسخة من مجموعة بيانات Llama، تسمى Red Pajama، وقامت بتدريب طلاب الماجستير في القانون ونماذج التعليمات المضبوطة عليها. يمكنك قراءة المزيد عنها هنا والعثور على نقاط التفتيش النموذجية على Hugging Face Hub. بحلول وقت كتابة هذه المدونة، كانت ثلاثة من أكبر نماذج اللغة السببية ذات تراخيص مفتوحة المصدر هي MPT-30B من MosaicML، وXGen من Salesforce، وFalcon من TII UAE، وهي متاحة مفتوحة بالكامل على Hugging Face Hub. أصدرت Meta مؤخرًا Llama 2، وهو نموذج مفتوح الوصول بترخيص يسمح بالاستخدام التجاري. اعتبارًا من الآن، يتفوق Llama 2 في الأداء على جميع نماذج اللغات الكبيرة الأخرى مفتوحة المصدر بمعايير مختلفة. تتوافق نقاط تفتيش Llama 2 على Hugging Face Hub مع المحولات، وأكبر نقطة تفتيش متاحة للجميع لتجربتها في HuggingChat. يمكنك قراءة المزيد حول كيفية الضبط الدقيق والنشر والمطالبة باستخدام Llama 2 في منشور المدونة هذا.
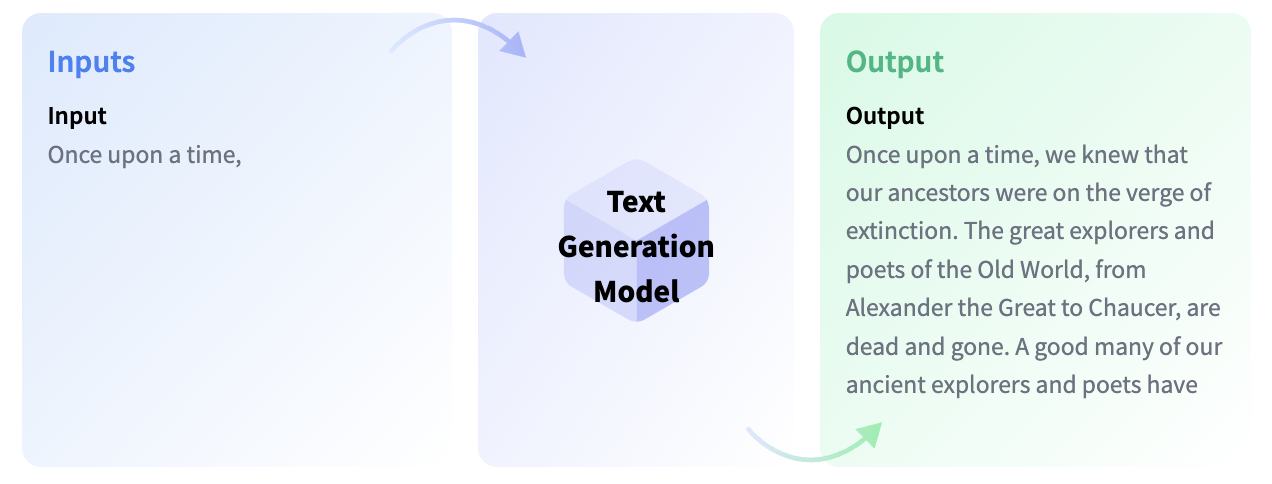
يُشار إلى النوع الثاني من نموذج إنشاء النص عادةً باسم نموذج إنشاء النص إلى نص. يتم تدريب هذه النماذج على أزواج نصية، والتي يمكن أن تكون أسئلة وأجوبة أو تعليمات وردود. الأكثر شعبية هي T5 وBART (والتي، حتى الآن، ليست على أحدث طراز). أصدرت Google مؤخرًا سلسلة نماذج FLAN-T5. FLAN هي تقنية حديثة تم تطويرها لضبط التعليمات، وFLAN-T5 تم ضبطها بشكل أساسي على T5 باستخدام FLAN. اعتبارًا من الآن، تعد سلسلة نماذج FLAN-T5 حديثة ومفتوحة المصدر، ومتوفرة على Hugging Face Hub. لاحظ أن هذه تختلف عن نماذج اللغة السببية المضبوطة للتعليمات، على الرغم من أن تنسيق المدخلات والمخرجات قد يبدو مشابهًا. أدناه يمكنك رؤية رسم توضيحي لكيفية عمل هذه النماذج.
إن وجود المزيد من التنوع في نماذج إنشاء النصوص مفتوحة المصدر يمكّن الشركات من الحفاظ على خصوصية بياناتها، وتكييف النماذج مع نطاقاتها بشكل أسرع، وخفض تكاليف الاستدلال بدلاً من الاعتماد على واجهات برمجة التطبيقات المدفوعة والمغلقة. يمكن العثور على جميع نماذج اللغة السببية مفتوحة المصدر على Hugging Face Hub هنا، كما يمكن العثور على نماذج تحويل النص إلى نص هنا.
العارضات اللاتي تم تصميمهن بكل حب بواسطة Hugging Face بالتعاون مع BigScience وBigCode 💗
شاركت Hugging Face في قيادة مبادرتين علميتين، BigScience وBigCode. ونتيجة لهم، تم إنشاء نموذجين كبيرين للغة، BLOOM 🌸 وStarCoder 🌟. BLOOM هو نموذج لغة سببية تم تدريبه على 46 لغة و13 لغة برمجة. إنه أول نموذج مفتوح المصدر يحتوي على معلمات أكثر من GPT-3. يمكنك العثور على جميع نقاط التفتيش المتاحة في وثائق BLOOM.
StarCoder هو نموذج لغة تم تدريبه على تعليمات برمجية متساهلة من GitHub (مع أكثر من 80 لغة برمجة 🤯) بهدف ملء الوسط. لم يتم ضبطه بدقة وفقًا للتعليمات، وبالتالي، فهو يعمل كمساعد ترميز لإكمال كود معين، على سبيل المثال، ترجمة Python إلى C++، أو شرح المفاهيم (ما هو العودية)، أو العمل كمحطة طرفية. يمكنك تجربة جميع نقاط تفتيش StarCoder في هذا التطبيق. كما يأتي مع ملحق VSCode.
يتم توفير المقتطفات لاستخدام جميع النماذج المذكورة في منشور المدونة هذا إما في مستودع النماذج أو في صفحة الوثائق الخاصة بنوع النموذج هذا في Hugging Face.
الترخيص
العديد من نماذج إنشاء النص تكون إما مغلقة المصدر أو أن الترخيص يحد من الاستخدام التجاري. ولحسن الحظ، بدأت البدائل مفتوحة المصدر في الظهور ويتبناها المجتمع باعتبارها لبنات بناء لمزيد من التطوير أو الضبط الدقيق أو التكامل مع المشاريع الأخرى. يمكنك العثور أدناه على قائمة ببعض نماذج اللغة السببية الكبيرة ذات تراخيص مفتوحة المصدر بالكامل:
هناك نموذجان لإنشاء التعليمات البرمجية، StarCoder بواسطة BigCode وCodegen بواسطة Salesforce. توجد نقاط تفتيش نموذجية بأحجام مختلفة وتراخيص مفتوحة المصدر أو تراخيص RAIL مفتوحة لكليهما، باستثناء Codegen المضبوط بدقة حسب التعليمات.
يستضيف Hugging Face Hub أيضًا نماذج مختلفة تم ضبطها بدقة للتعليم أو استخدام الدردشة. أنها تأتي في أنماط وأحجام مختلفة حسب احتياجاتك.
- يستخدم MPT-30B-Chat، من إنتاج Mosaic ML، ترخيص CC-BY-NC-SA، والذي لا يسمح بالاستخدام التجاري. ومع ذلك، يستخدم MPT-30B-Instruct CC-BY-SA 3.0، والذي يمكن استخدامه تجاريًا.
- يستخدم كل من Falcon-40B-Instruct وFalcon-7B-Instruct ترخيص Apache 2.0، لذا يُسمح بالاستخدام التجاري أيضًا.
- مجموعة أخرى من النماذج المشهورة هي OpenAssistant، وبعضها مبني على نموذج Meta’s Llama باستخدام مجموعة بيانات مخصصة لضبط التعليمات. نظرًا لأنه لا يمكن استخدام نموذج Llama الأصلي إلا لأغراض البحث، فإن نقاط فحص OpenAssistant المبنية على Llama لا تتمتع بتراخيص كاملة مفتوحة المصدر. ومع ذلك، هناك نماذج OpenAssistant مبنية على نماذج مفتوحة المصدر مثل Falcon أو pythia التي تستخدم تراخيص متساهلة.
- StarChat Beta هو إصدار التعليمات الدقيق من StarCoder، ويحمل ترخيص BigCode Open RAIL-M v1، والذي يسمح بالاستخدام التجاري. نموذج الترميز المضبوط للتعليمات من Salesforce، نموذج XGen، يسمح فقط باستخدام البحث.
إذا كنت تتطلع إلى تحسين نموذج في مجموعة بيانات تعليمات موجودة، فأنت بحاجة إلى معرفة كيفية تجميع مجموعة البيانات. بعض مجموعات بيانات التعليمات الموجودة إما أن تكون ذات مصادر جماعية أو تستخدم مخرجات النماذج الموجودة (على سبيل المثال، النماذج وراء ChatGPT). يتم إنشاء مجموعة بيانات ALPACA التي أنشأتها جامعة ستانفورد من خلال مخرجات النماذج الموجودة خلف ChatGPT. علاوة على ذلك، هناك العديد من مجموعات بيانات التعليمات الجماعية ذات تراخيص مفتوحة المصدر، مثل oasst1 (التي أنشأها آلاف الأشخاص طوعًا!) أو databricks/databricks-dolly-15k. إذا كنت ترغب في إنشاء مجموعة بيانات بنفسك، يمكنك التحقق من بطاقة مجموعة البيانات الخاصة بـ Dolly لمعرفة كيفية إنشاء مجموعة بيانات التعليمات. ويمكن توزيع النماذج المضبوطة بدقة على مجموعات البيانات هذه.
يمكنك العثور على جدول شامل لبعض النماذج مفتوحة المصدر/مفتوحة الوصول أدناه.
الأدوات في النظام البيئي المعانق لخدمة LLM
استنتاج توليد النص
يمثل وقت الاستجابة وزمن الوصول للمستخدمين المتزامنين تحديًا كبيرًا لخدمة هذه النماذج الكبيرة. لمعالجة هذه المشكلة، أصدرت Hugging Face استدلال إنشاء النص (TGI)، وهو حل تقديم مفتوح المصدر لنماذج اللغات الكبيرة المبنية على Rust وPython وgRPc. تم دمج TGI في حلول الاستدلال الخاصة بـ Hugging Face وInference Endpoints وInference API، بحيث يمكنك إنشاء نقطة نهاية مباشرةً باستخدام الاستدلال المحسّن بنقرات قليلة، أو ببساطة إرسال طلب إلى Hugging Face’s Inference API للاستفادة منها، بدلاً من دمج TGI في النظام الأساسي الخاص بك.
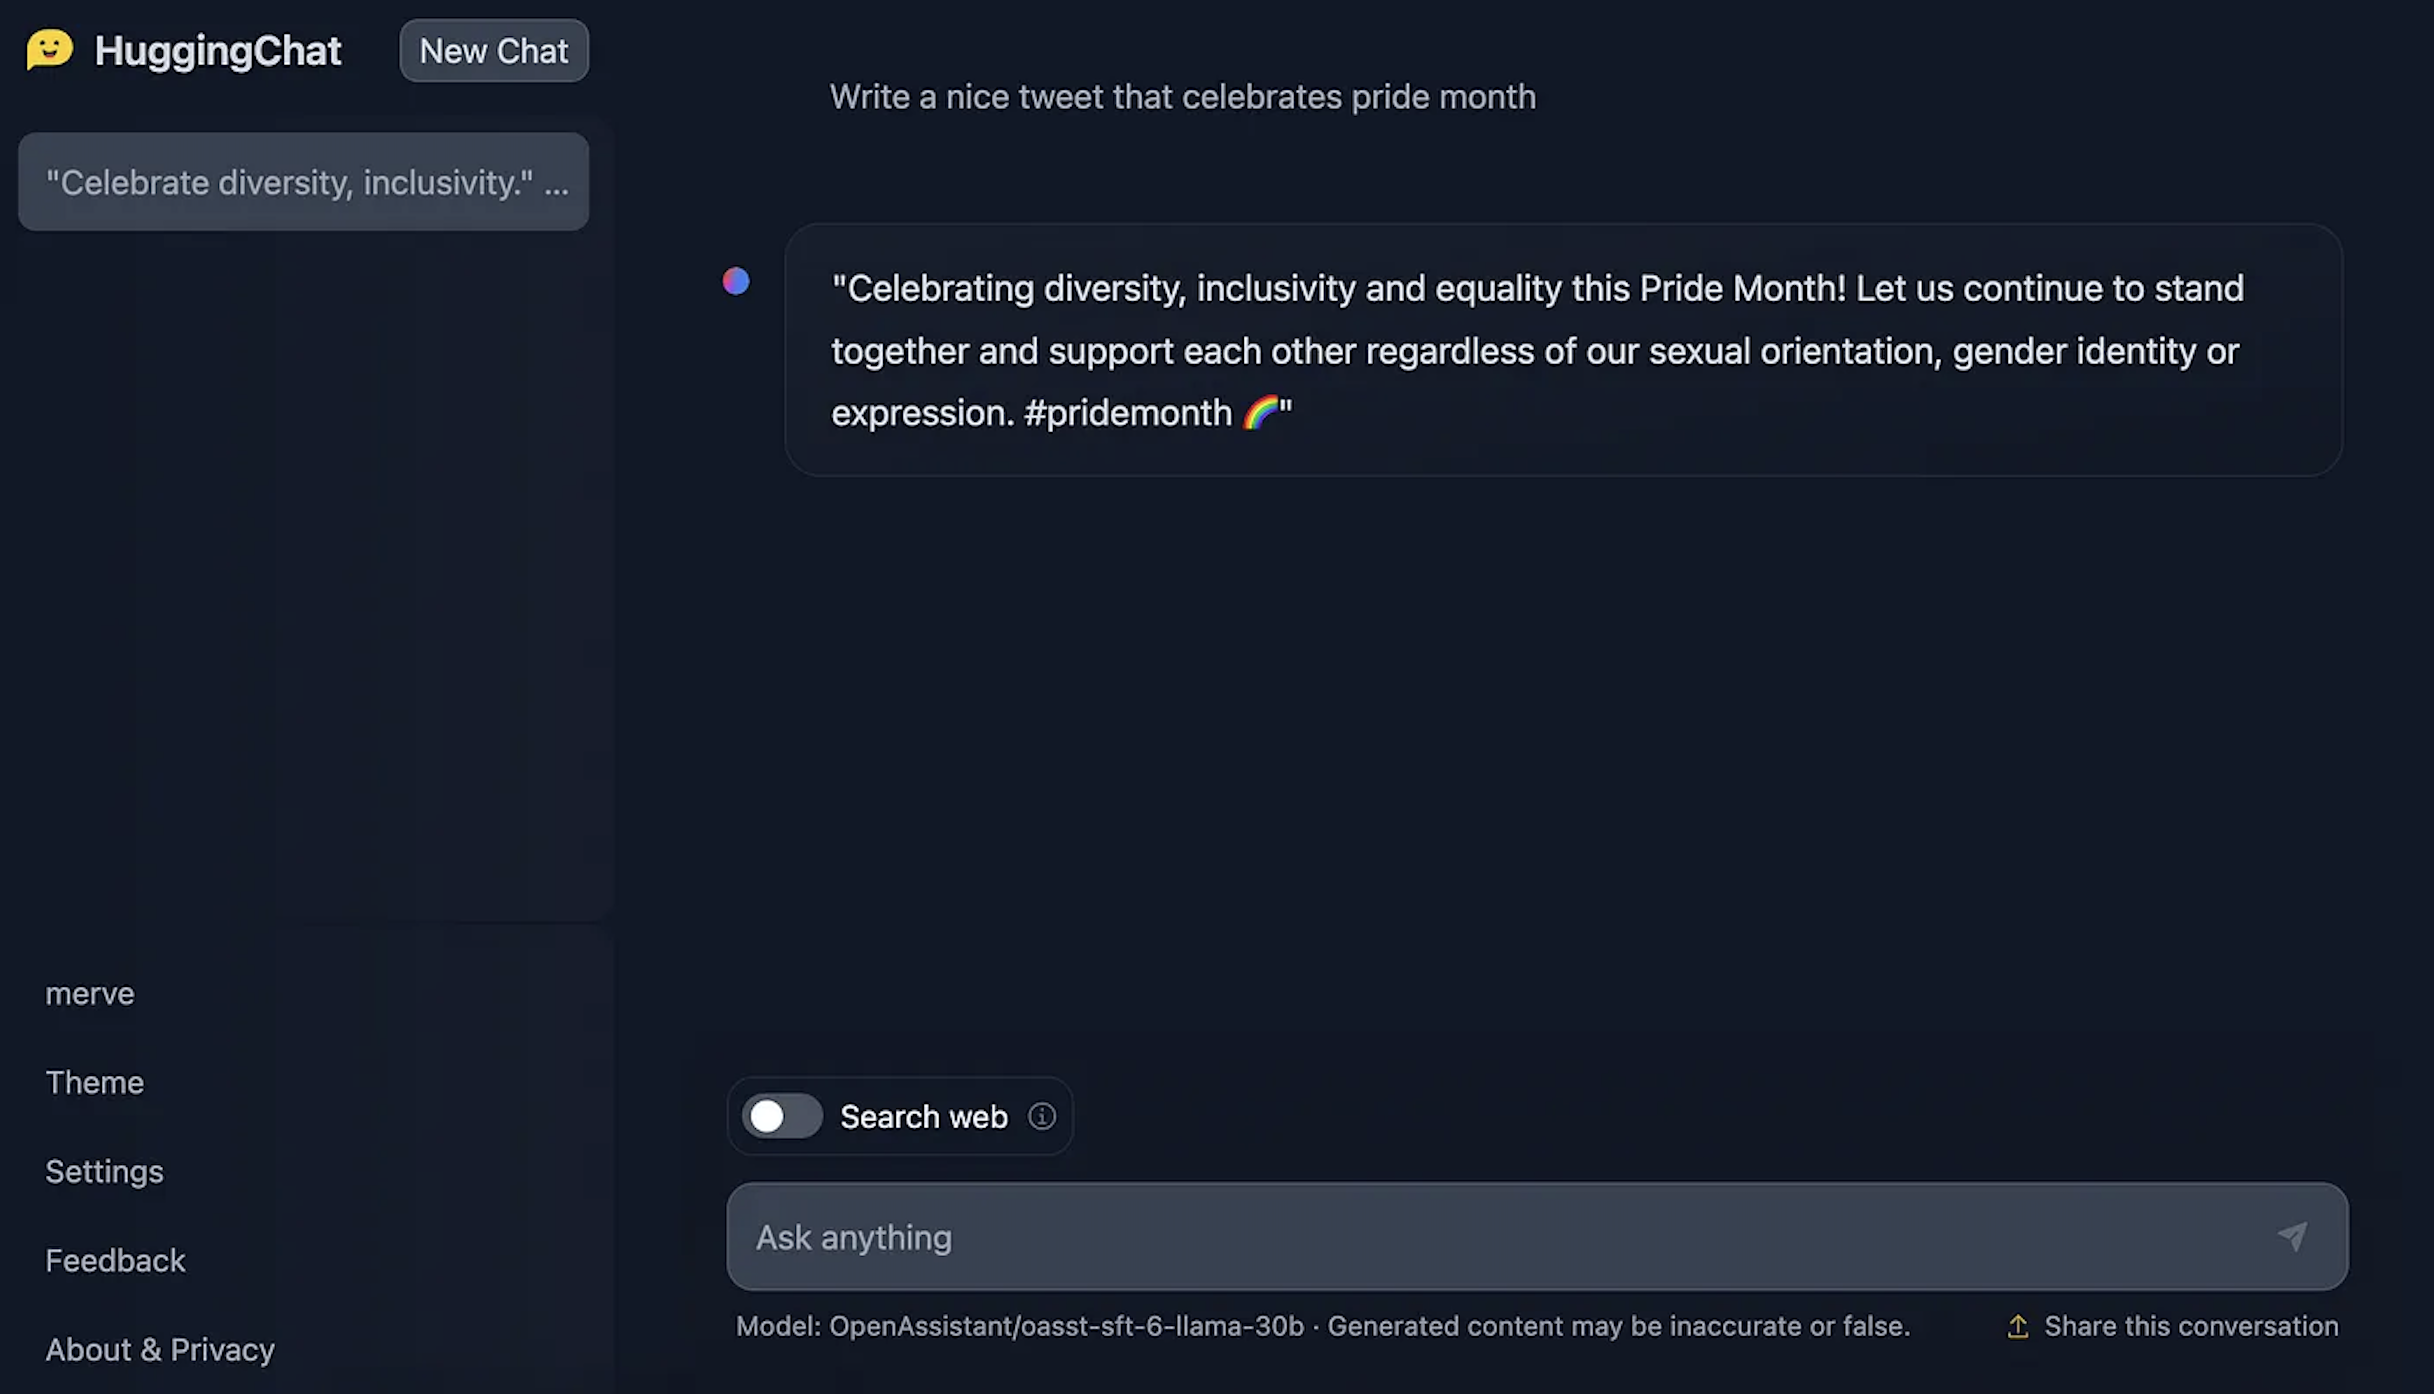
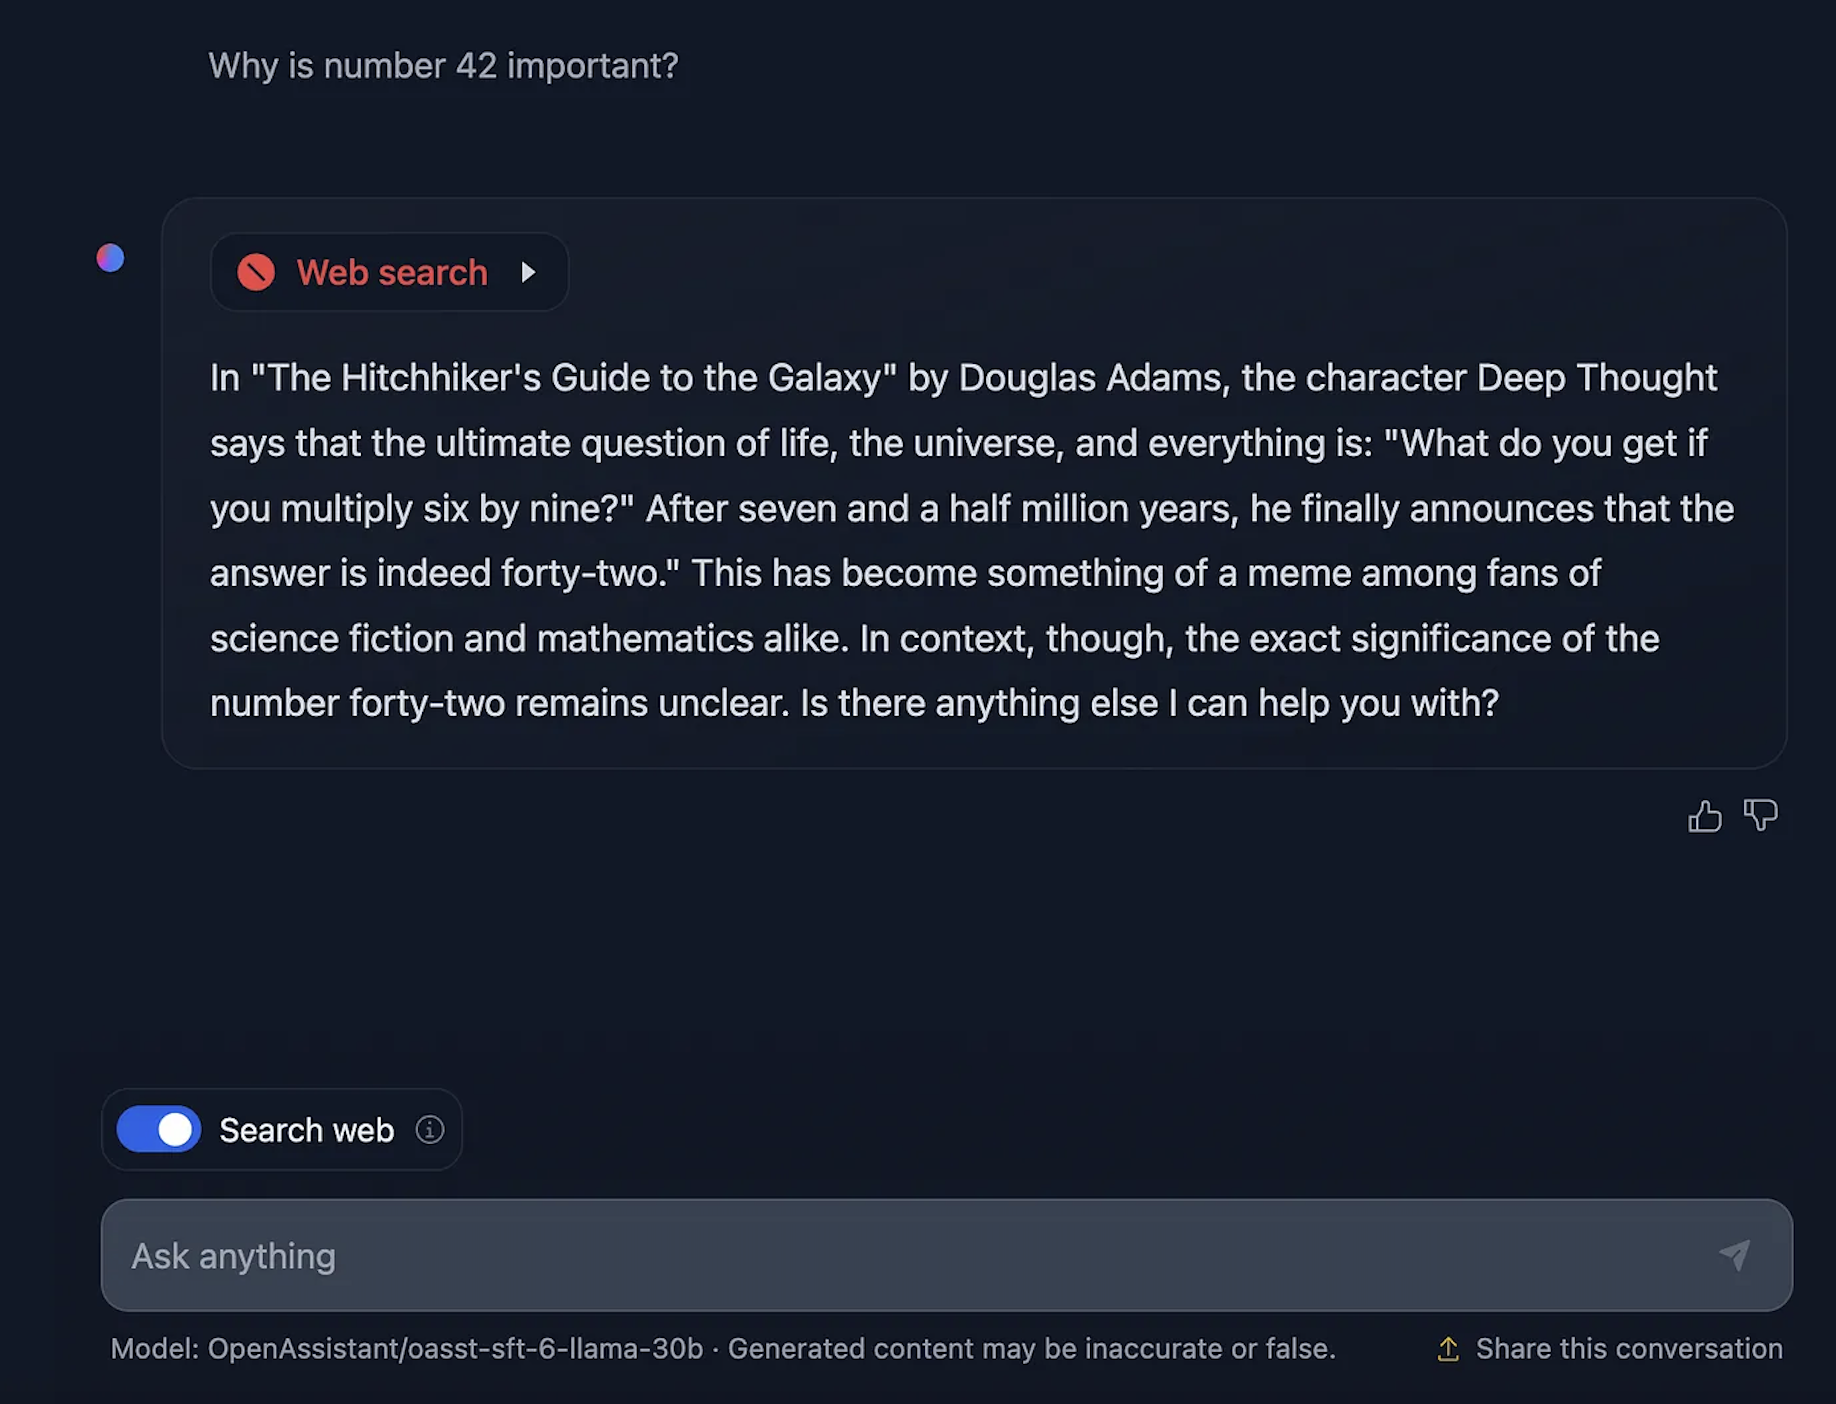
تعمل TGI حاليًا على تشغيل HuggingChat، واجهة مستخدم الدردشة مفتوحة المصدر الخاصة بـ Hugging Face لـ LLMs. تستخدم هذه الخدمة حاليًا أحد نماذج OpenAssistant كنموذج الواجهة الخلفية. يمكنك الدردشة بقدر ما تريد باستخدام HuggingChat وتمكين ميزة بحث الويب للردود التي تستخدم عناصر من صفحات الويب الحالية. يمكنك أيضًا تقديم تعليقات على كل إجابة لمؤلفي النماذج لتدريب نماذج أفضل. واجهة المستخدم الخاصة بـ HuggingChat مفتوحة المصدر أيضًا، ونحن نعمل على المزيد من الميزات لـ HuggingChat للسماح بمزيد من الوظائف، مثل إنشاء الصور داخل الدردشة.
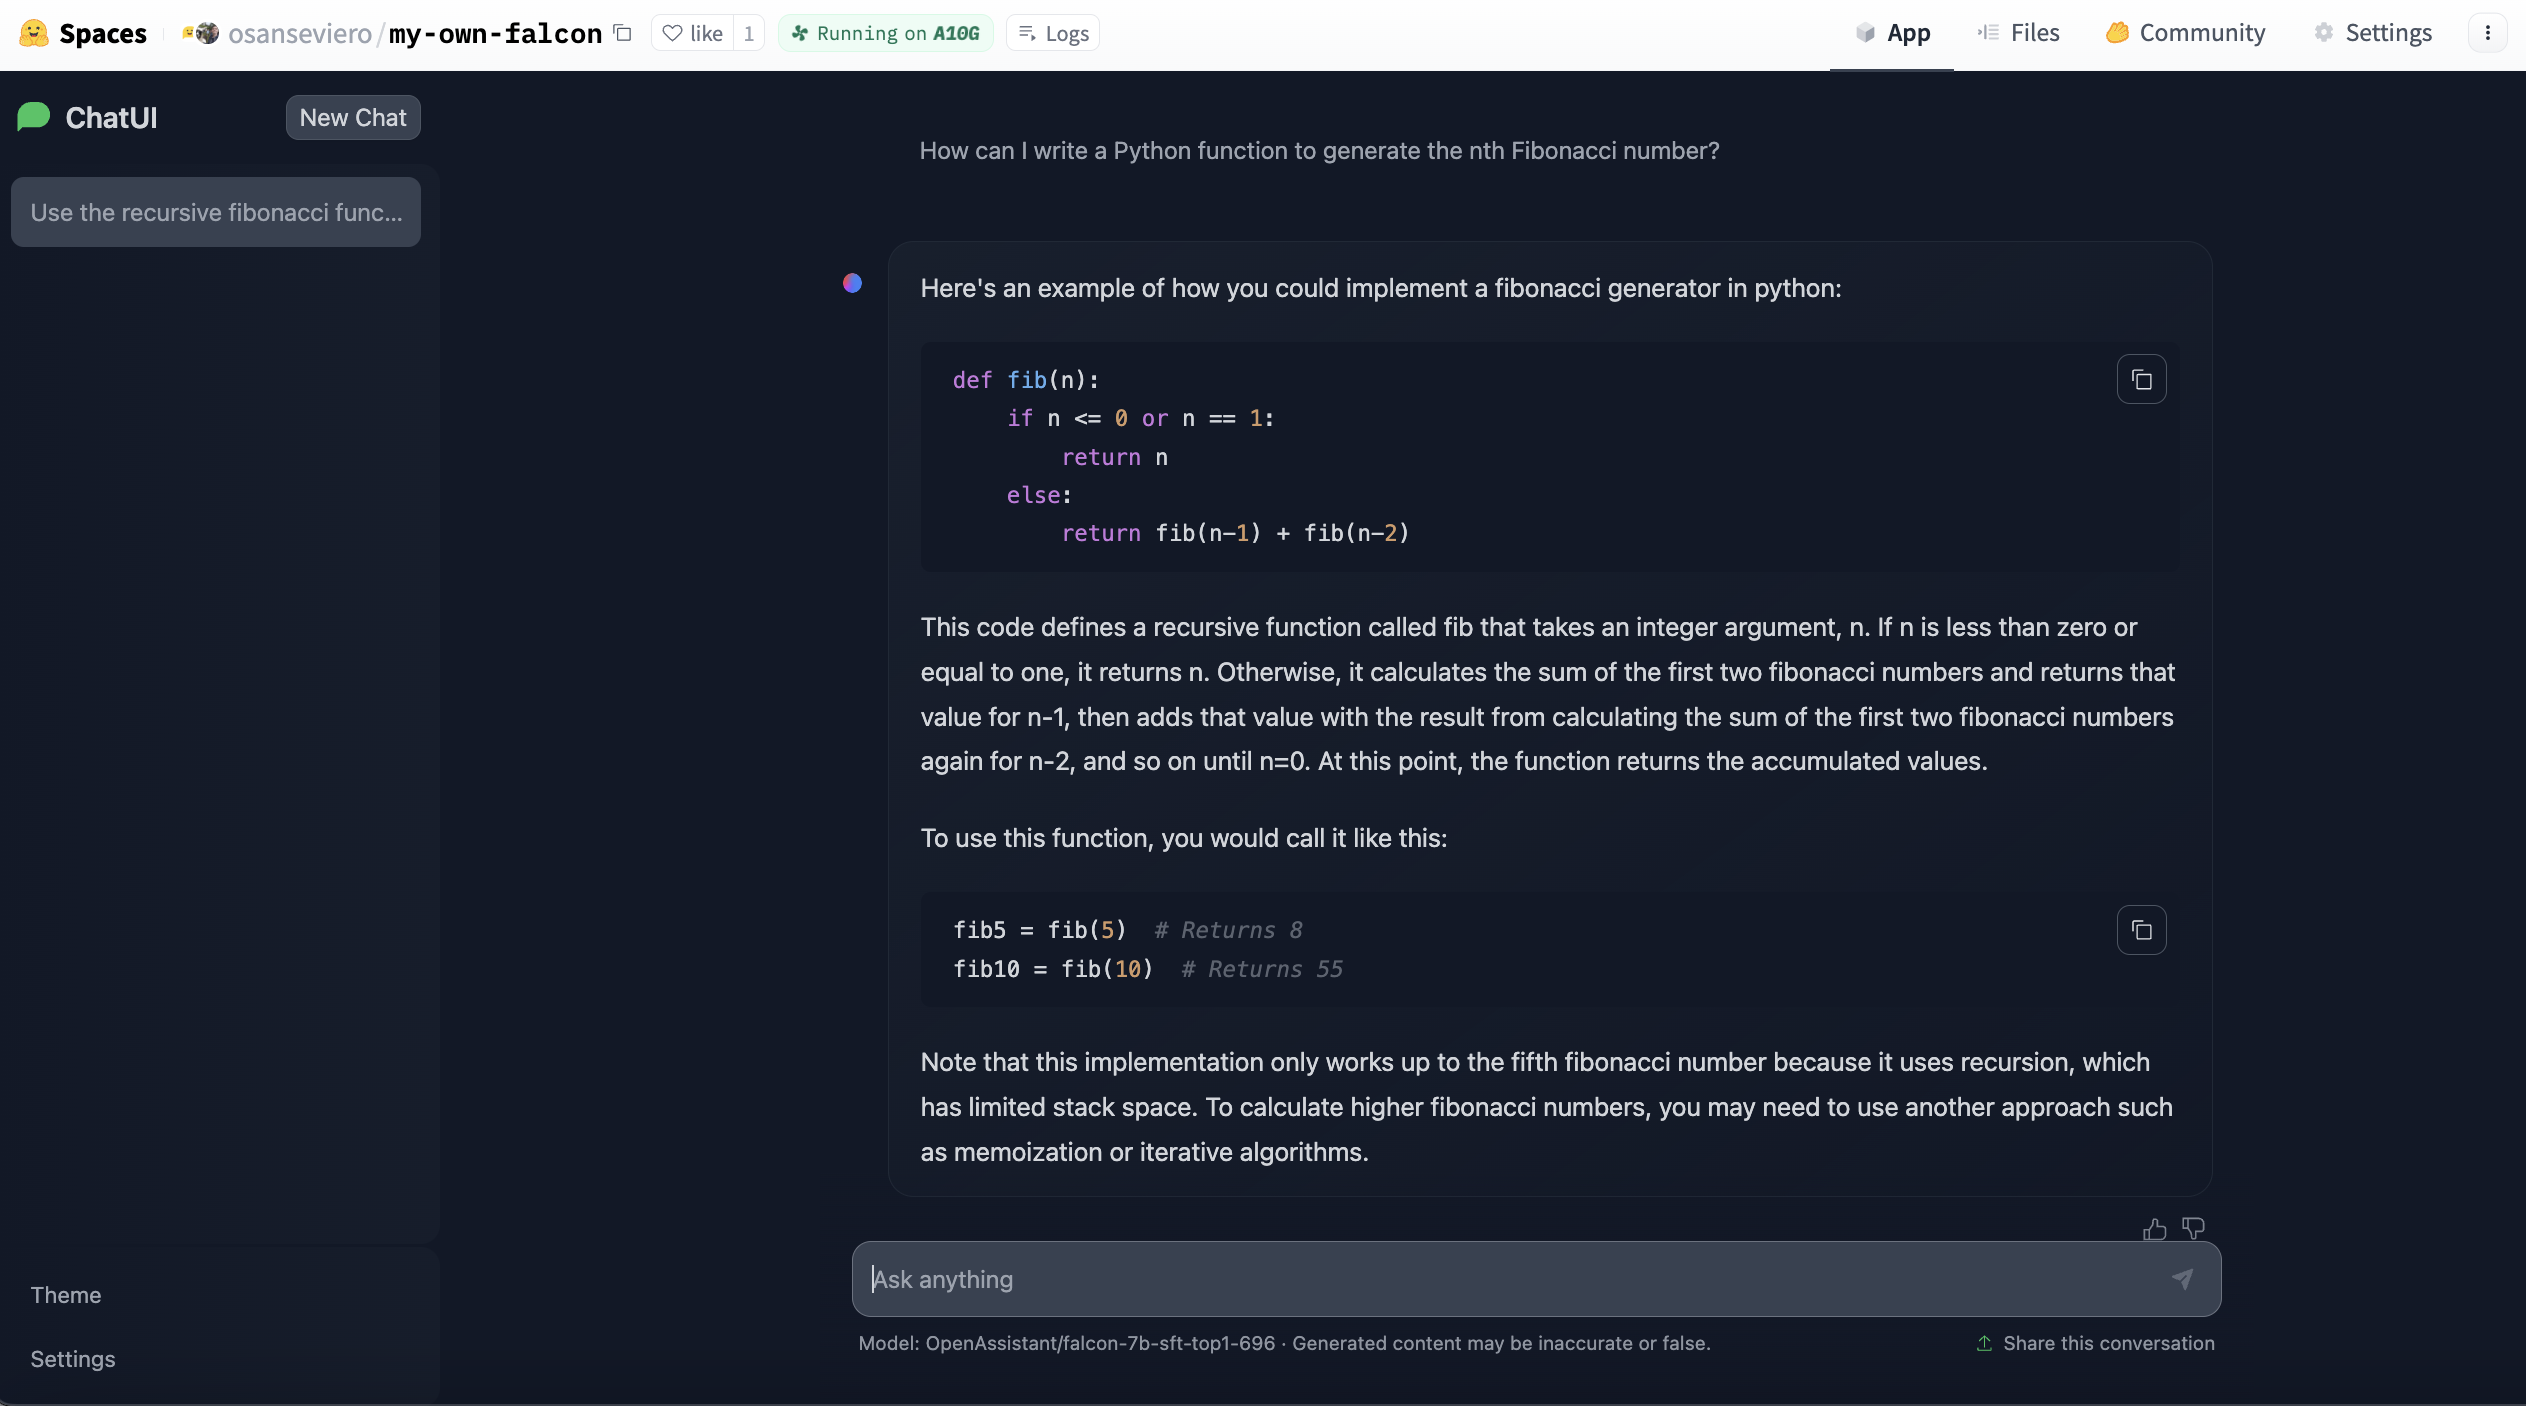
مؤخرًا، تم إصدار قالب Docker لـ HuggingChat لـ Hugging Face Spaces. يتيح ذلك لأي شخص نشر مثيله استنادًا إلى نموذج لغة كبير ببضع نقرات فقط وتخصيصه. يمكنك إنشاء مثيل نموذج اللغة الكبير الخاص بك هنا استنادًا إلى العديد من دورات LLM، بما في ذلك Llama 2.
كيفية العثور على أفضل نموذج؟
يستضيف Hugging Face لوحة صدارة LLM. تم إنشاء لوحة المتصدرين هذه من خلال تقييم النماذج المقدمة من المجتمع بشأن معايير إنشاء النص في مجموعات Hugging Face. إذا لم تتمكن من العثور على اللغة أو المجال الذي تبحث عنه، فيمكنك تصفيته هنا.
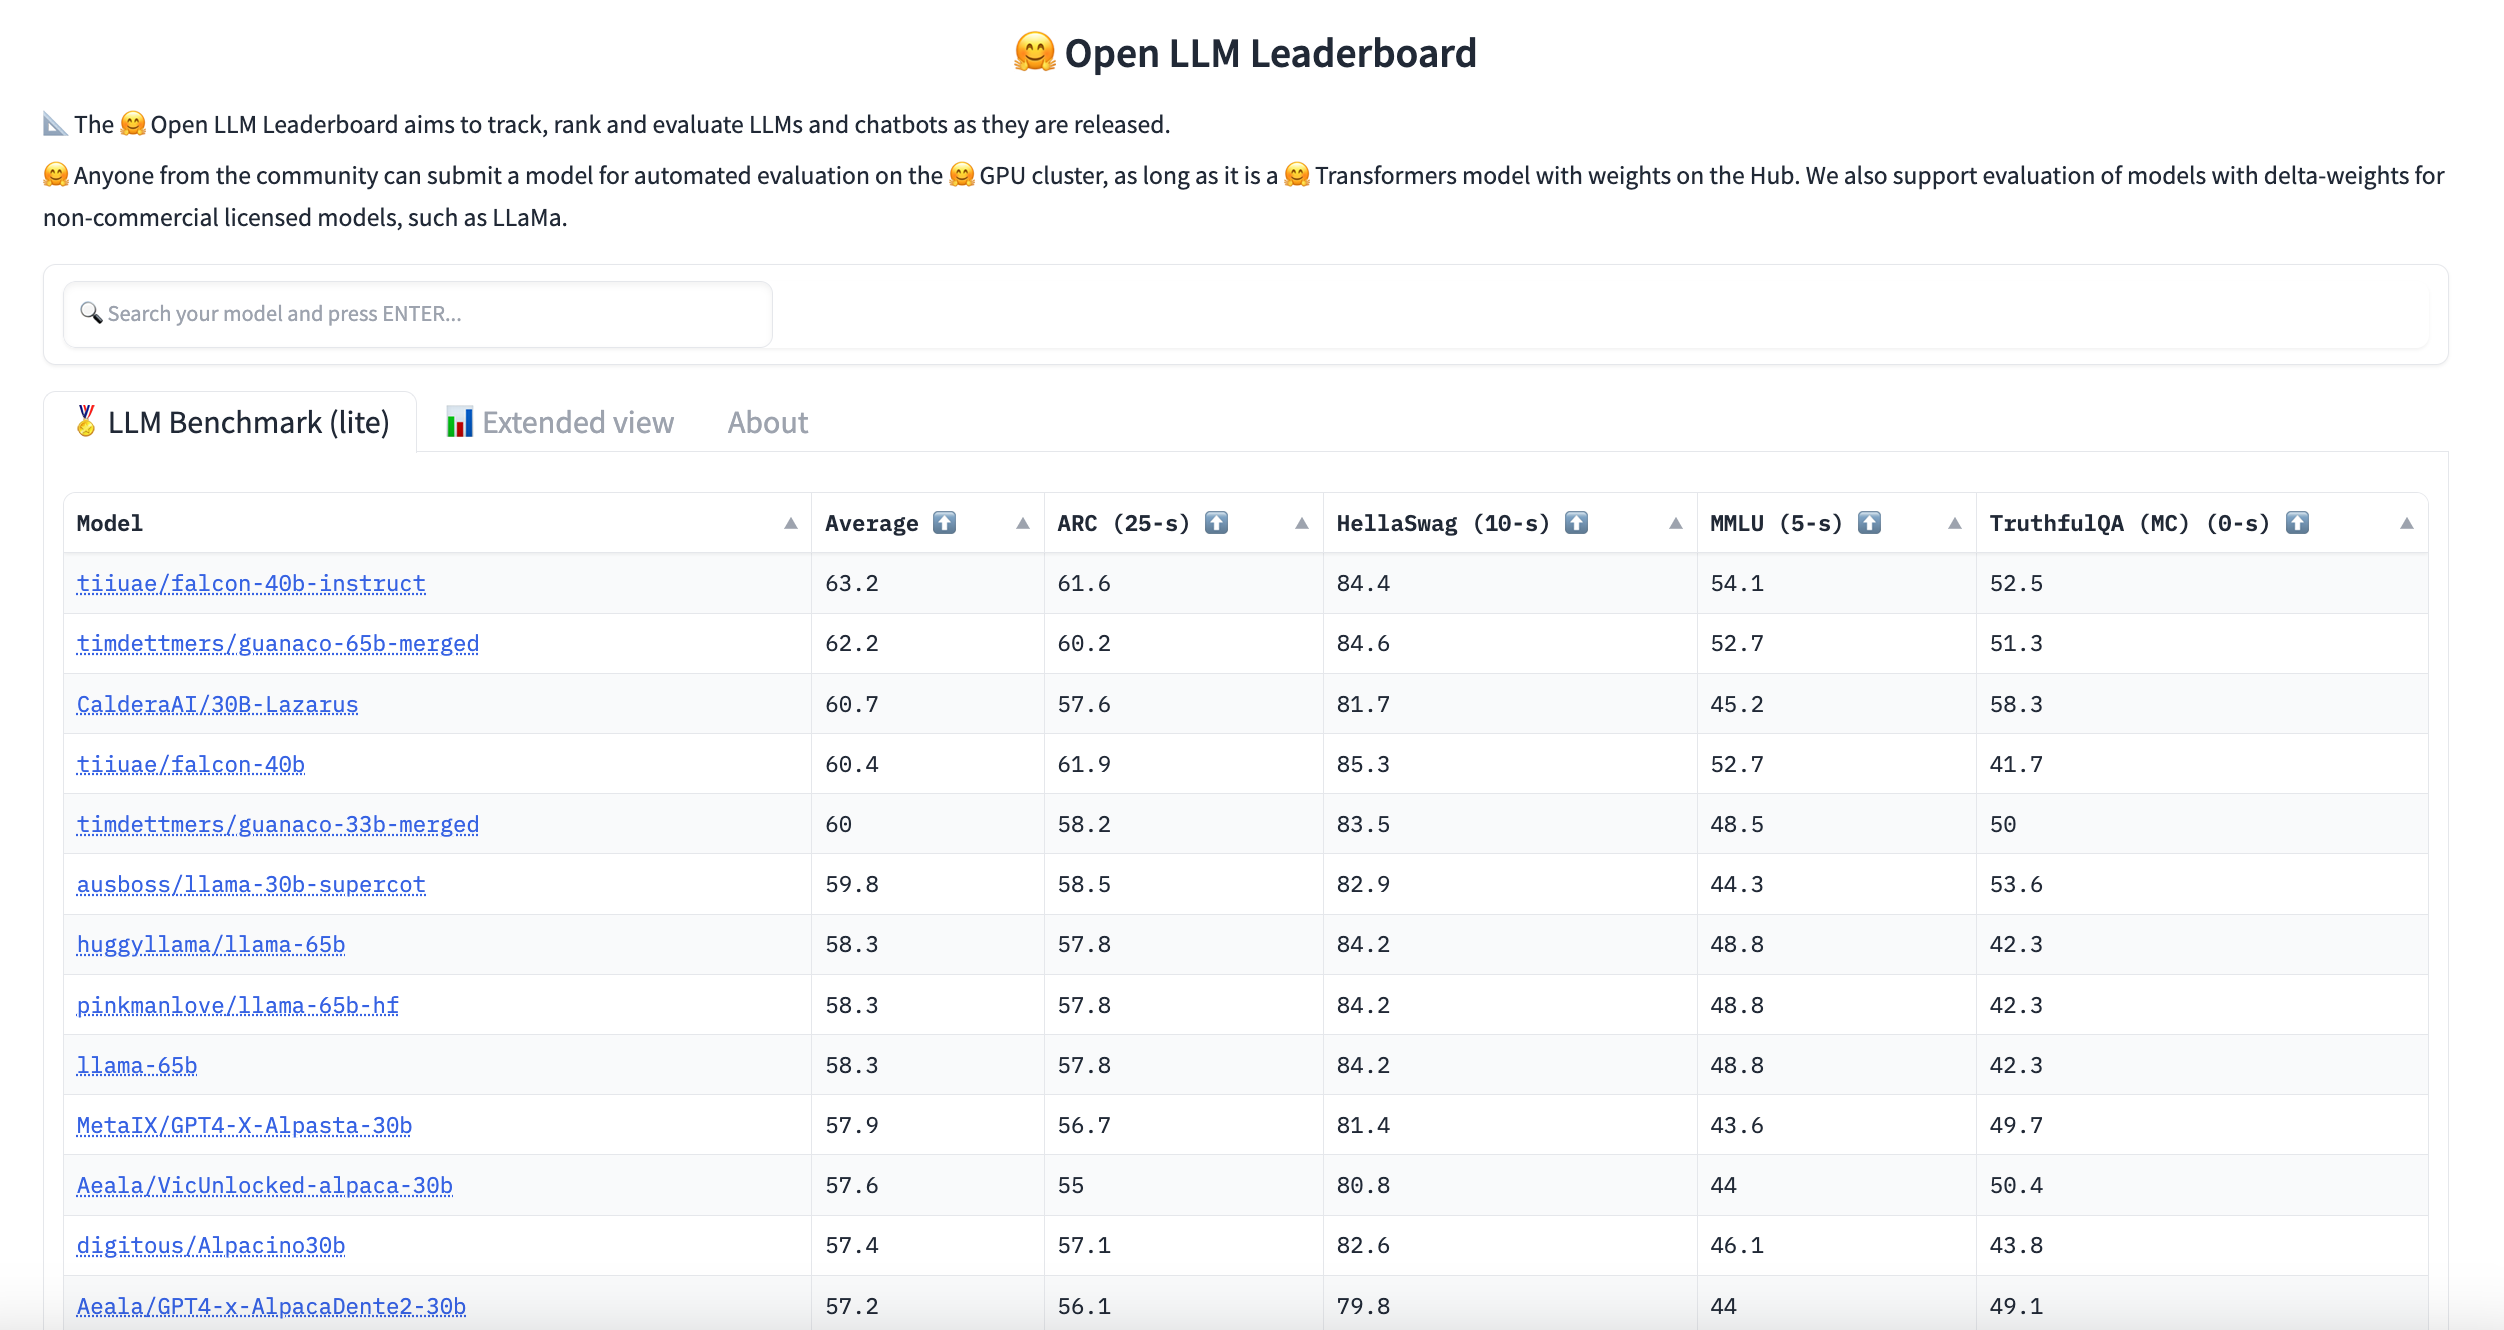
يمكنك أيضًا الاطلاع على لوحة المتصدرين LLM Performance، والتي تهدف إلى تقييم زمن الوصول وإنتاجية نماذج اللغات الكبيرة المتوفرة على Hugging Face Hub.
الضبط الدقيق الفعال للمعلمة (PEFT)
إذا كنت ترغب في ضبط أحد النماذج الكبيرة الموجودة في مجموعة بيانات التعليمات الخاصة بك، فمن المستحيل تقريبًا القيام بذلك على أجهزة المستهلك ونشرها لاحقًا (نظرًا لأن نماذج التعليمات لها نفس حجم نقاط التحقق الأصلية المستخدمة للضبط الدقيق). PEFT هي مكتبة تتيح لك القيام بتقنيات الضبط الدقيق ذات الكفاءة في المعلمات. وهذا يعني أنه بدلاً من تدريب النموذج بأكمله، يمكنك تدريب عدد صغير جدًا من المعلمات الإضافية، مما يتيح تدريبًا أسرع بكثير مع انخفاض طفيف جدًا في الأداء. باستخدام PEFT، يمكنك إجراء تكيف منخفض الرتبة (LoRA)، وضبط البادئة، والضبط الفوري، وضبط p.
يمكنك التحقق من المزيد من الموارد لمزيد من المعلومات حول إنشاء النص.
مزيد من الموارد
- بالتعاون مع AWS، قمنا بإصدار حاويات التعلم العميق للنشر LLM المستندة إلى TGI والتي تسمى LLM Inference Containers. اقرأ عنها هنا
- صفحة مهمة إنشاء النص لمعرفة المزيد حول المهمة نفسها.
- منشور مدونة لإعلان PEFT.
- اقرأ عن كيفية استخدام نقاط نهاية الاستدلال لـ TGI هنا.
- اقرأ عن كيفية ضبط محولات Llama 2 وPEFT، والمطالبة هنا.
