

نحن متحمسون لتقديم نموذج فعال لتحويل النص إلى صورة غير منتشر باسم مستمتع. يطلق عليه ذلك لأنه نسخة مفتوحة من MUSE من Google. جودة إنتاج aMUSEd ليست الأفضل ونحن نصدر معاينة بحثية بترخيص متساهل.
على النقيض من نهج الانتشار الكامن الشائع الاستخدام (Rombach et al. (2022))، يستخدم aMUSEd منهجية نموذج الصورة المقنعة (MIM). وهذا لا يتطلب فقط خطوات استدلال أقل، كما لاحظ تشانغ وآخرون. (2023)، ولكنه يعزز أيضًا إمكانية تفسير النموذج.
وكما هو الحال مع MUSE، يُظهر aMUSEd قدرة استثنائية على نقل النمط باستخدام صورة واحدة، وهي ميزة تم استكشافها بعمق بواسطة Sohn et al. (2023). يمكن أن يفتح هذا الجانب آفاقًا جديدة في إنشاء صور مخصصة ومحددة النمط.
في منشور المدونة هذا، سنقدم لك بعض العناصر الداخلية لبرنامج aMUSEd، ونوضح كيف يمكنك استخدامه لمهام مختلفة، بما في ذلك تحويل النص إلى صورة، ونوضح كيفية ضبطه. على طول الطريق، سنوفر جميع الموارد المهمة المتعلقة بـ aMUSEd، بما في ذلك كود التدريب الخاص به. لنبدأ 🚀
جدول المحتويات
لقد قمنا ببناء عرض توضيحي للقراء للعب مع aMUSEd. يمكنك تجربتها في هذه المساحة أو في الملعب المضمن أدناه:
كيف يعمل؟
يعتمد aMUSEd على نمذجة الصور المقنعة. إنه يمثل حالة استخدام مقنعة للمجتمع لاستكشاف المكونات المعروفة بأنها تعمل في نمذجة اللغة في سياق توليد الصور.
يعرض الشكل أدناه نظرة عامة مصورة لكيفية عمل aMUSEd.
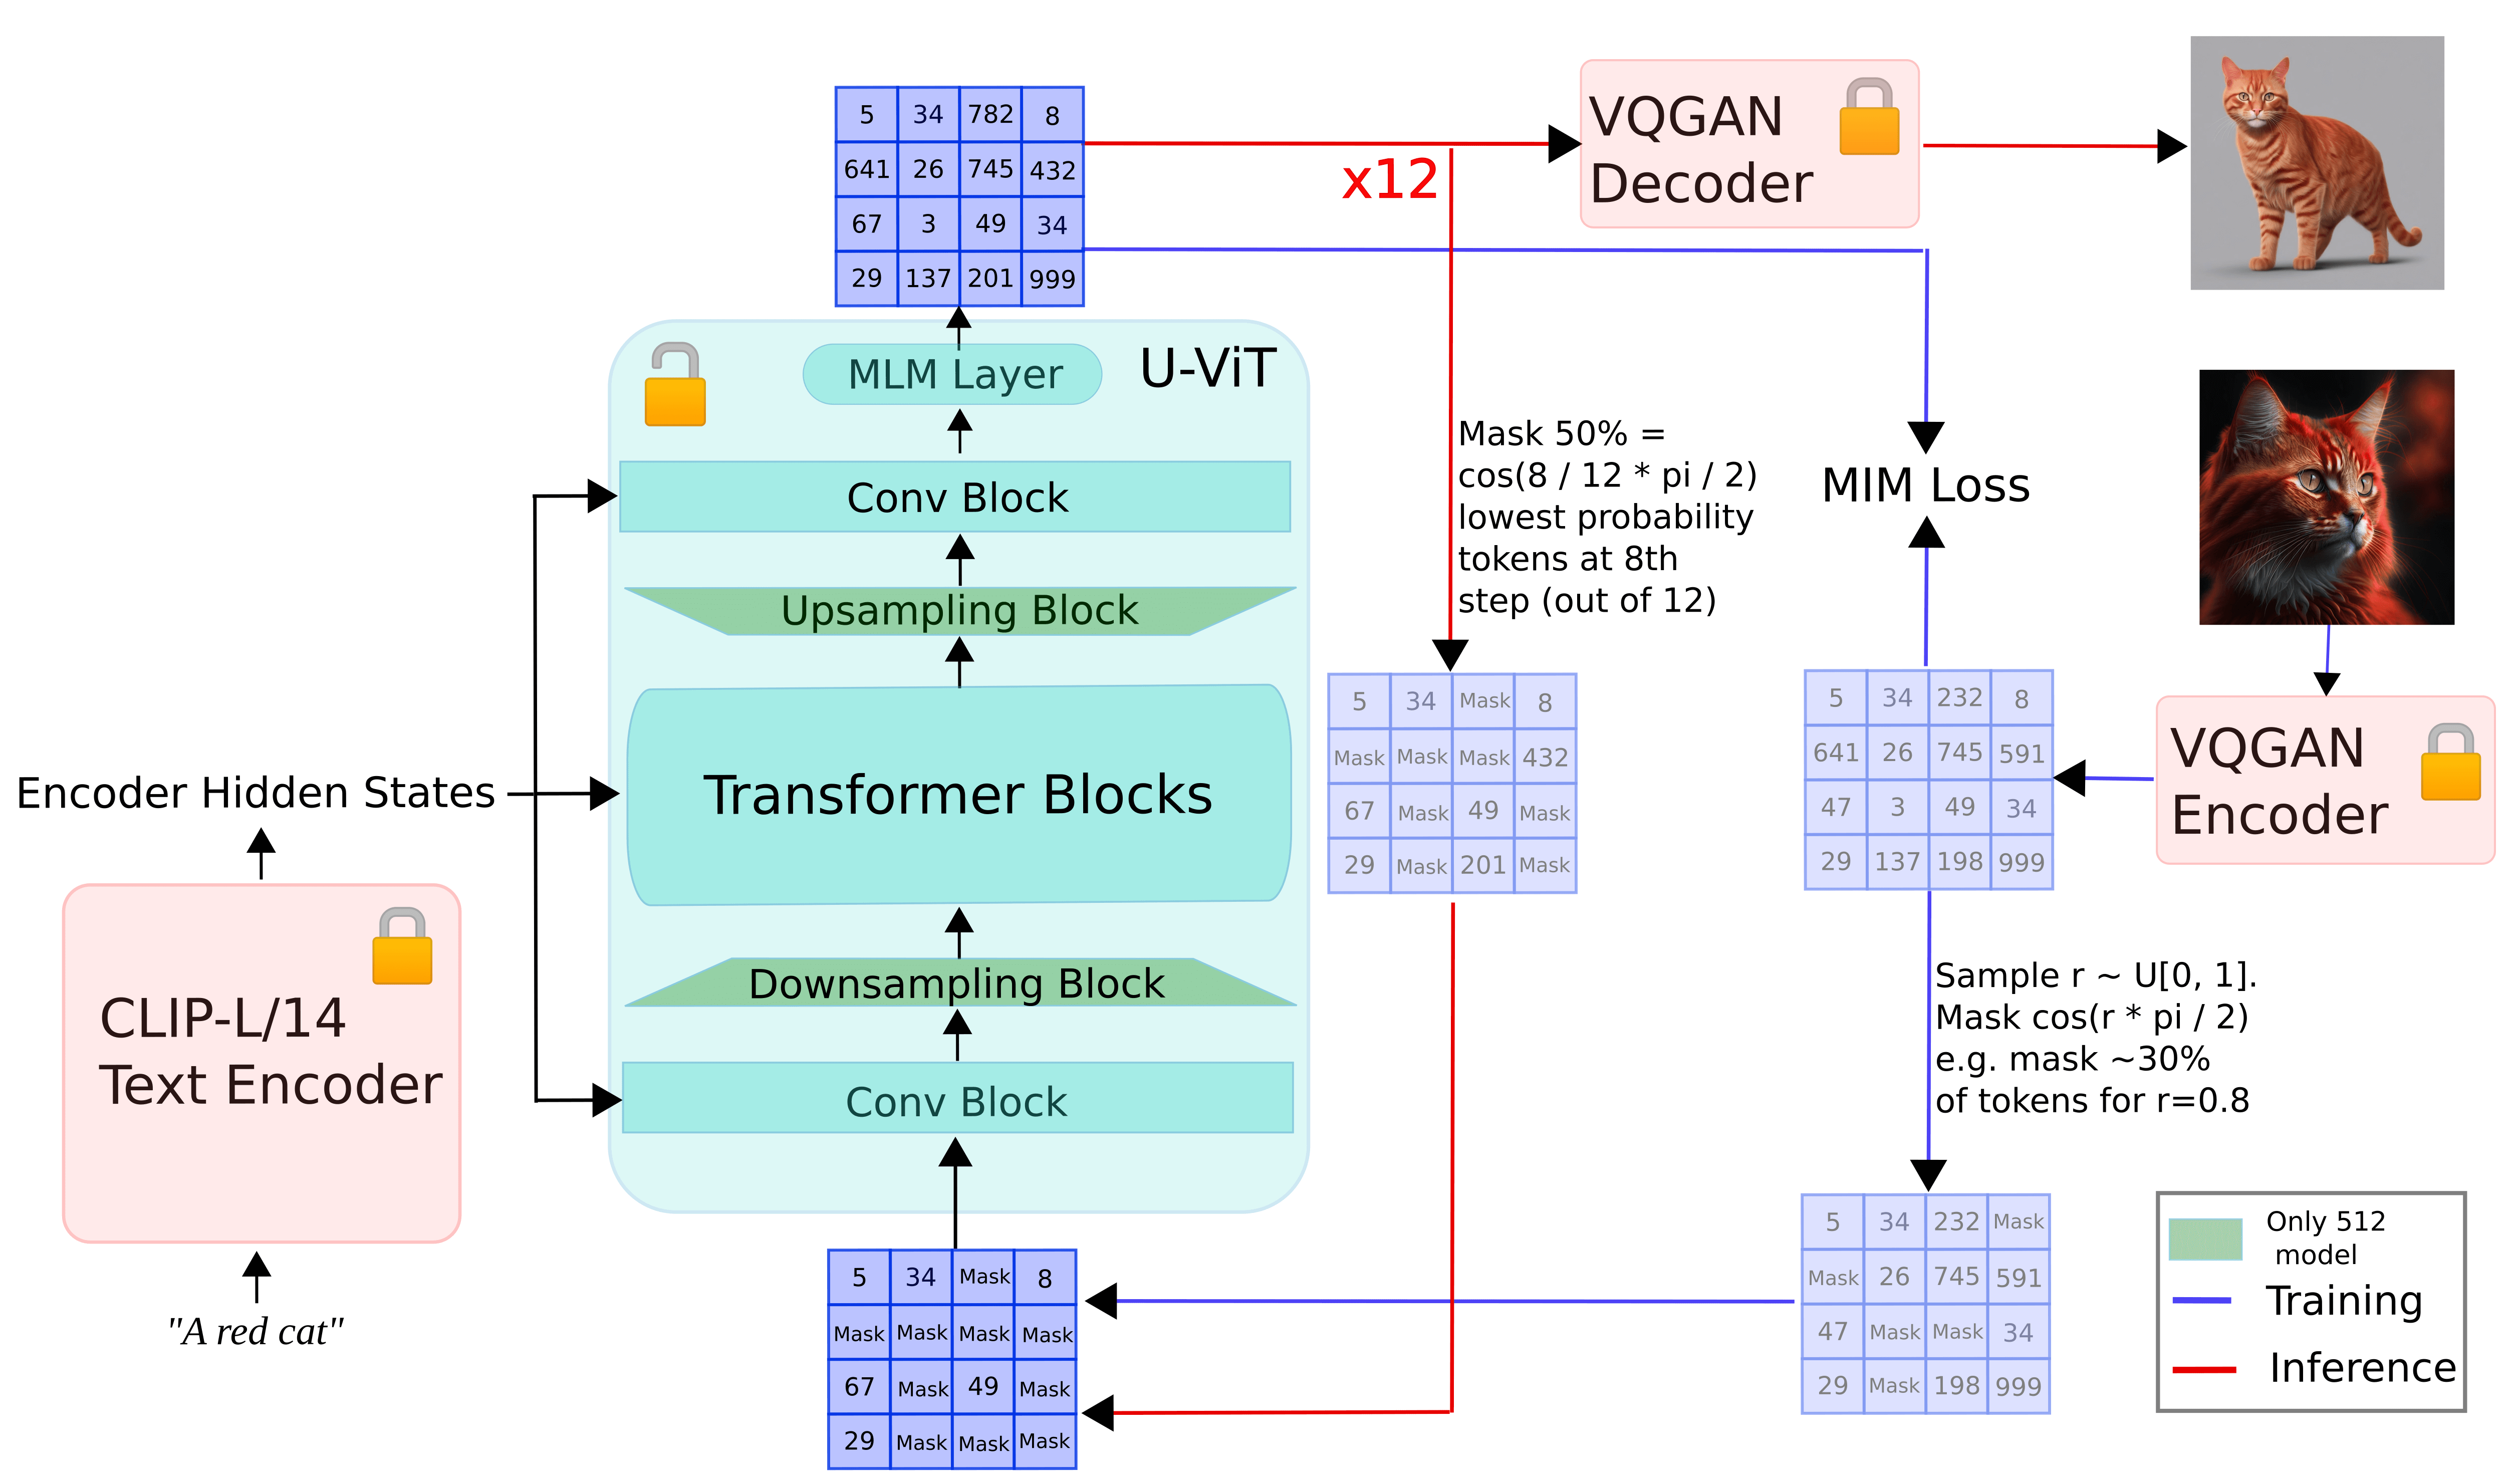
خلال تمرين:
- يتم ترميز الصور المدخلة باستخدام VQGAN للحصول على الرموز المميزة للصورة
- يتم بعد ذلك إخفاء الرموز المميزة للصورة وفقًا لجدول إخفاء جيب التمام.
- يتم تمرير الرموز المميزة المقنعة (المشروطة بالتضمينات الفورية المحسوبة باستخدام برنامج تشفير النص CLIP-L/14 إلى نموذج U-ViT الذي يتنبأ بالتصحيحات المقنعة
خلال الاستدلال:
- يتم تضمين موجه الإدخال باستخدام برنامج تشفير النص CLIP-L/14.
- كرر حتى
Nتم الوصول إلى الخطوات:- ابدأ بالرموز المميزة المقنعة بشكل عشوائي وقم بتمريرها إلى نموذج U-ViT جنبًا إلى جنب مع التضمينات السريعة
- توقع الرموز المميزة المقنعة واحتفظ فقط بنسبة معينة من التنبؤات الأكثر ثقة بناءً على
Nوجدول القناع. قم بإخفاء العناصر المتبقية وتمريرها إلى نموذج U-ViT
- قم بتمرير الإخراج النهائي إلى وحدة فك ترميز VQGAN للحصول على الصورة النهائية
كما ذكرنا في البداية، فإن aMUSEd يستعير الكثير من أوجه التشابه من MUSE. ومع ذلك، هناك بعض الاختلافات الملحوظة:
- لا يتبع aMUSEd منهجًا مكونًا من مرحلتين للتنبؤ بالتصحيحات المقنعة النهائية.
- بدلاً من استخدام T5 لتكييف النص، يتم استخدام CLIP L/14 لحساب تضمينات النص.
- بعد Stable Diffusion XL (SDXL)، يتم تمرير التكييف الإضافي، مثل حجم الصورة والاقتصاص، إلى U-ViT. ويشار إلى هذا باسم “التكييف الجزئي”.
لمعرفة المزيد عن aMUSEd، نوصي بقراءة التقرير الفني هنا.
استخدام aMUSEd في 🧨 الناشرون
يأتي aMUSEd مدمجًا بالكامل في أجهزة توزيع الروائح. لاستخدامه، نحتاج أولاً إلى تثبيت المكتبات:
pip install -U diffusers accelerate transformers -q
لنبدأ بإنشاء تحويل النص إلى صورة:
import torch
from diffusers import AmusedPipeline

pipe = AmusedPipeline.from_pretrained(
    "amused/amused-512", variant="fp16", torch_dtype=torch.float16
)
pipe = pipe.to("cuda")

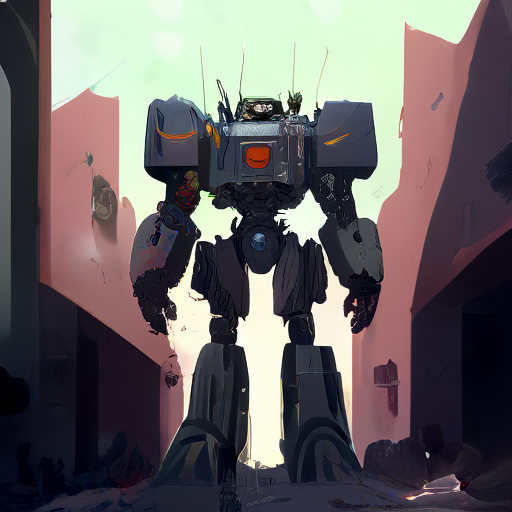
prompt = "A mecha robot in a favela in expressionist style"
negative_prompt = "low quality, ugly"

image = pipe(prompt, negative_prompt=negative_prompt, generator=torch.manual_seed(0)).images[0]
image
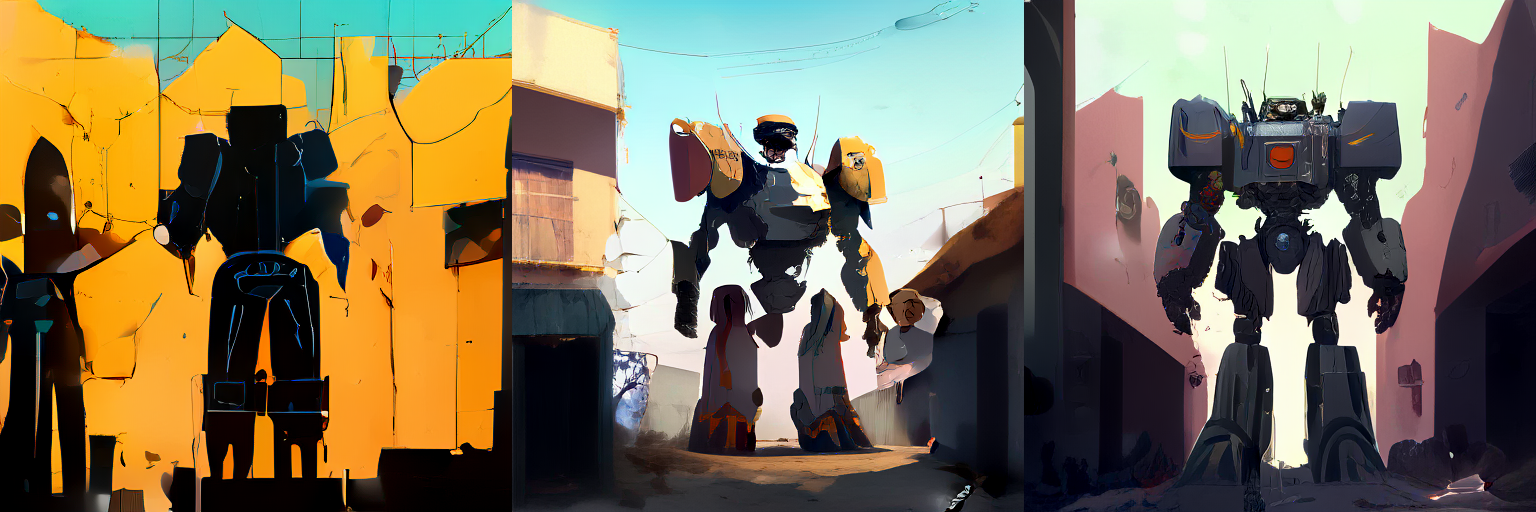
يمكننا أن ندرس كيف num_inference_steps يؤثر على جودة الصور تحت بذرة ثابتة:
from diffusers.utils import make_image_grid

images = []
for step in [5, 10, 15]:
    image = pipe(prompt, negative_prompt=negative_prompt, num_inference_steps=step, generator=torch.manual_seed(0)).images[0]
    images.append(image)

grid = make_image_grid(images, rows=1, cols=3)
grid
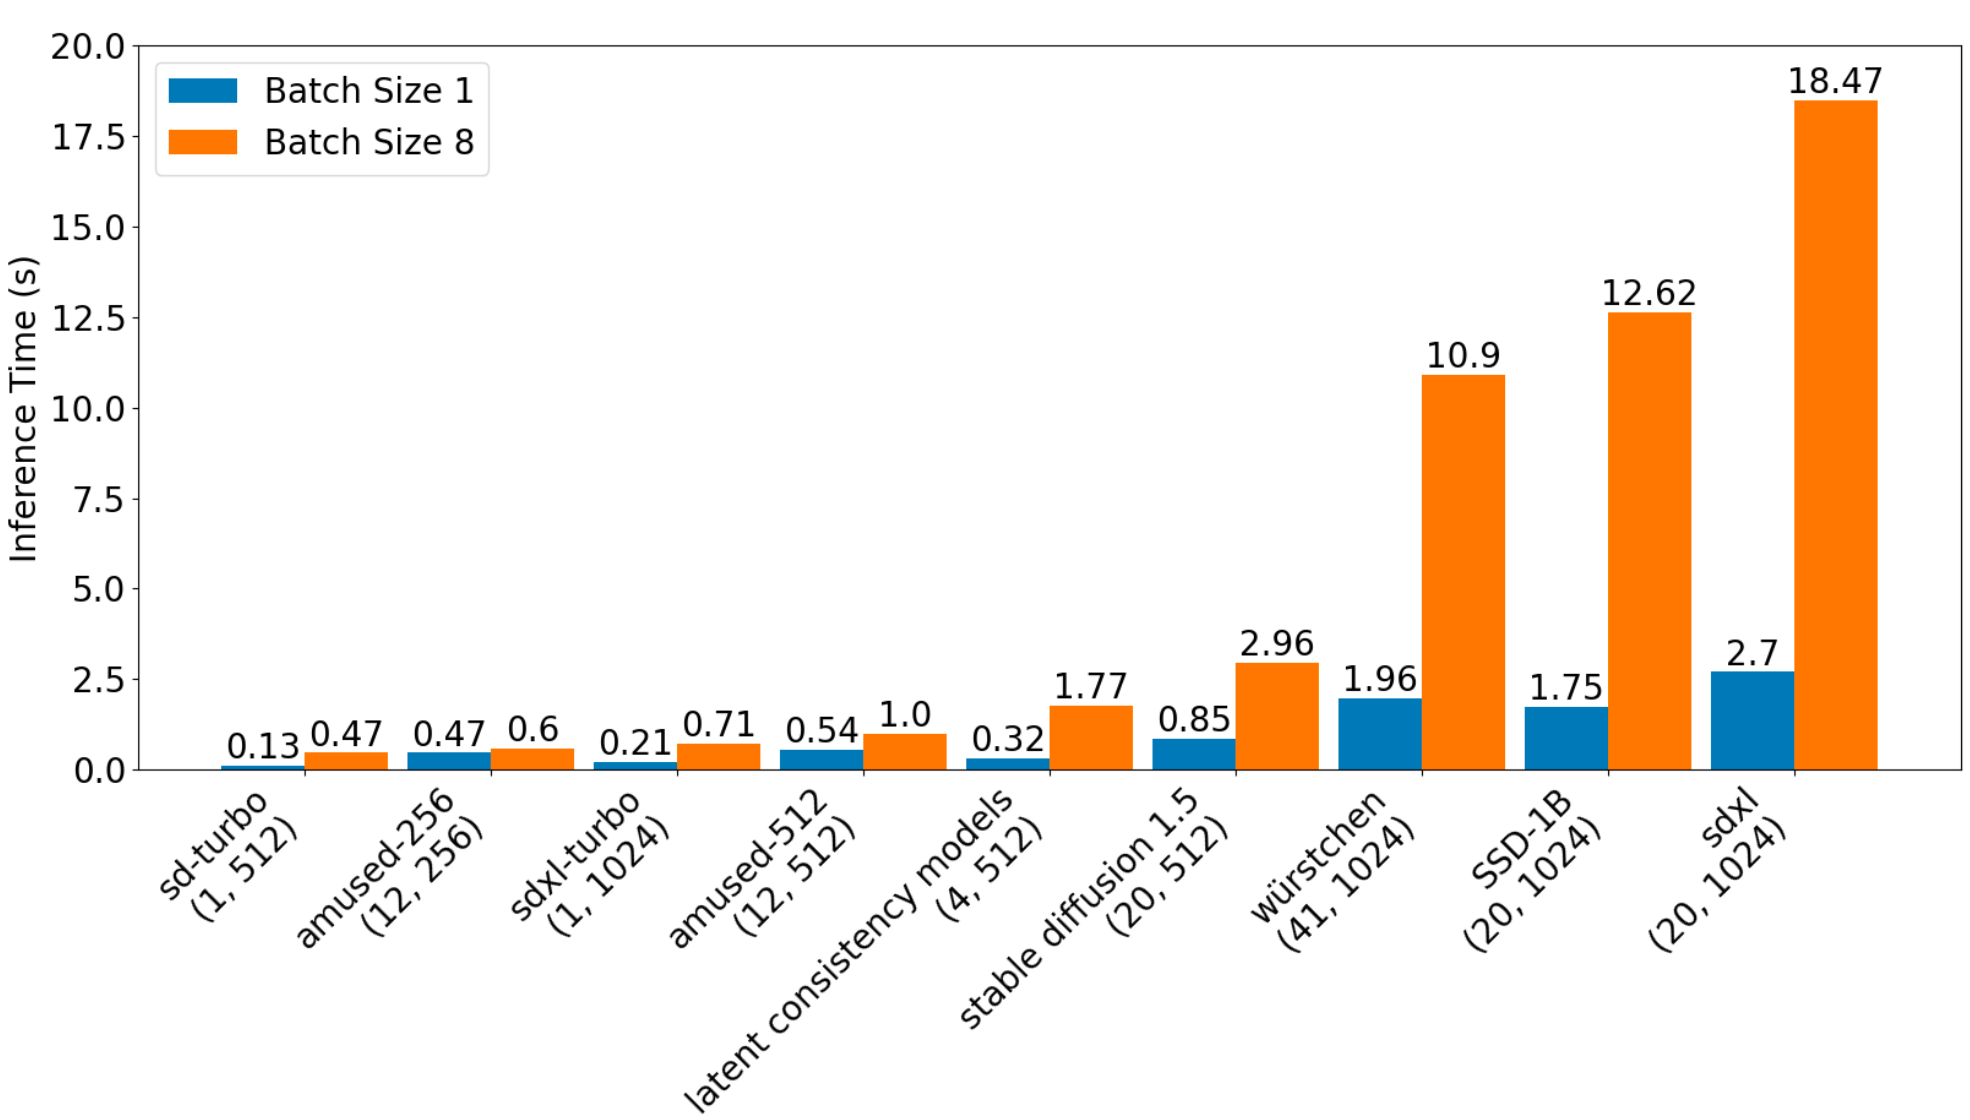
والأهم من ذلك، نظرًا لصغر حجمه (حوالي 800 مليون معلمة فقط، بما في ذلك برنامج تشفير النص وVQ-GAN)، فإن برنامج aMUSEd سريع جدًا. يقدم الشكل أدناه دراسة مقارنة لزمن الاستجابة الاستدلالي لنماذج مختلفة، بما في ذلك aMUSEd:
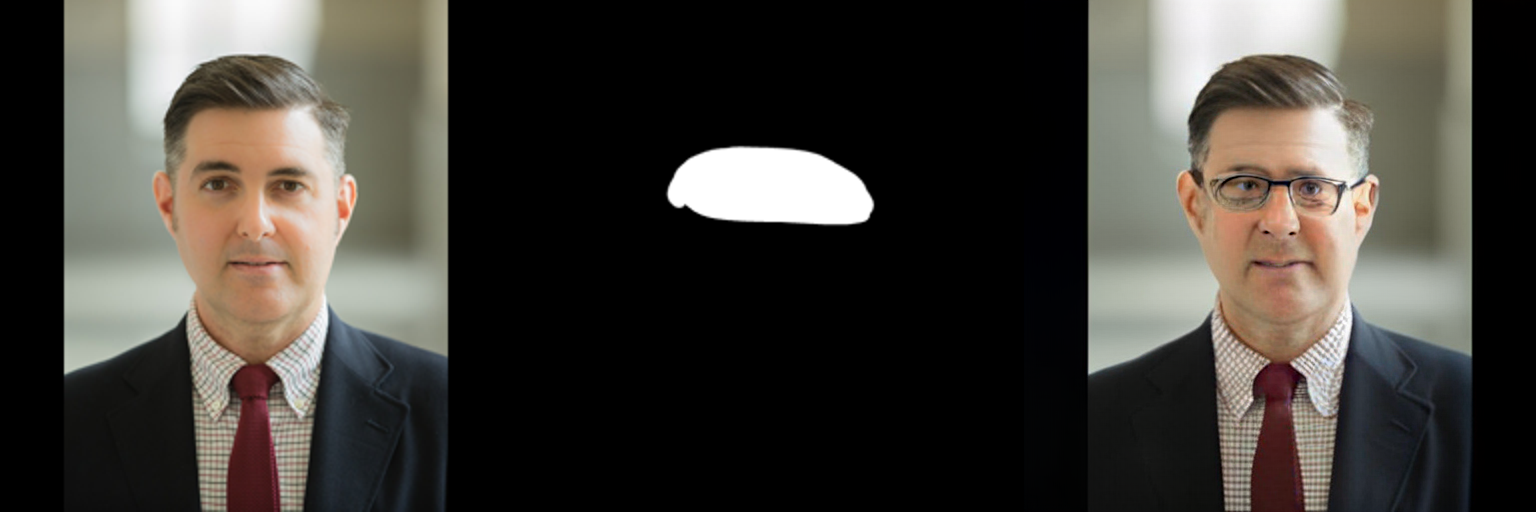
كنتيجة ثانوية مباشرة لهدف ما قبل التدريب، يمكن لـ aMUSEd القيام برسم الصور بلقطة صفرية، على عكس النماذج الأخرى مثل SDXL.
import torch
from diffusers import AmusedInpaintPipeline
from diffusers.utils import load_image
from PIL import Image

pipe = AmusedInpaintPipeline.from_pretrained(
    "amused/amused-512", variant="fp16", torch_dtype=torch.float16
)
pipe = pipe.to("cuda")

prompt = "a man with glasses"
input_image = (
    load_image(
        "https://huggingface.co/amused/amused-512/resolve/main/assets/inpainting_256_orig.png"
    )
    .resize((512, 512))
    .convert("RGB")
)
mask = (
    load_image(
        "https://huggingface.co/amused/amused-512/resolve/main/assets/inpainting_256_mask.png"
    )
    .resize((512, 512))
    .convert("L")
)

image = pipe(prompt, input_image, mask, generator=torch.manual_seed(3)).images[0]
aMUSEd هو أول نظام عدم انتشار في الداخل diffusers. إن نهجها في الجدولة التكرارية للتنبؤ بالتصحيحات المقنعة جعلها مرشحًا جيدًا لـ diffusers. نحن متحمسون لرؤية كيف يستفيد المجتمع من ذلك.
نحن نشجعك على مراجعة التقرير الفني للتعرف على جميع المهام التي اكتشفناها مع aMUSEd.
الضبط الدقيق مسلي
نحن نقدم برنامجًا تدريبيًا بسيطًا لضبط aMUSEd على مجموعات البيانات المخصصة. بفضل مُحسِّن Adam 8 بت ودقة float16، من الممكن ضبط جهاز aMUSEd باستخدام ما يقل قليلاً عن 11 جيجابايت من ذاكرة GPU VRAM. مع LoRA، يتم تقليل متطلبات الذاكرة إلى 7 جيجابايت فقط.
يأتي aMUSEd مزودًا بترخيص OpenRAIL، وبالتالي فهو ملائم تجاريًا للتكيف. راجع هذا الدليل لمزيد من التفاصيل حول الضبط الدقيق.
القيود
aMUSEd ليس جيلًا حديثًا من الصور فيما يتعلق بجودة الصورة. لقد أصدرنا برنامج aMUSEd لتشجيع المجتمع على استكشاف أطر عدم الانتشار مثل MIM لتوليد الصور. نعتقد أن إمكانات MIM لم يتم استكشافها بعد، نظرًا لفوائدها:
- كفاءة الاستدلال
- حجم أصغر، مما يتيح التطبيقات الموجودة على الجهاز
- نقل المهام دون الحاجة إلى ضبط دقيق باهظ الثمن
- مزايا المكونات الراسخة من عالم نمذجة اللغة
(لاحظ أن العمل الأصلي على MUSE قريب المصدر)
للحصول على وصف تفصيلي للتقييم الكمي لـ aMUSEd، راجع التقرير الفني.
نأمل أن يجد المجتمع الموارد مفيدة ويشعر بالتحفيز لتحسين حالة MIM لتوليد الصور.
موارد
أوراق:
كود + متفرقات:
شكر وتقدير
قاد سوراج التدريب. قاد ويليام البيانات ودعم التدريب. دعم باتريك فون بلاتن كلا من التدريب والبيانات وقدم إرشادات عامة. قام Robin Rombach بتدريب VQGAN وقدم إرشادات عامة. ساعد Isamu Isozaki في المناقشات الثاقبة وقدم مساهمات في الكود.
شكرًا لباتريك فون بلاتن وبيدرو كوينكا على مراجعتهما لمسودة منشور المدونة.
