

SetFitABSA هي تقنية فعالة لاكتشاف المشاعر تجاه جوانب معينة داخل النص.
تحليل المشاعر على أساس الجوانب (ABSA) هو مهمة اكتشاف المشاعر تجاه جوانب معينة داخل النص. على سبيل المثال، في الجملة، “يحتوي هذا الهاتف على شاشة رائعة، لكن بطاريته صغيرة جدًا”، وجه المصطلحان هما “شاشة” و”بطارية” وتكون قطبية المشاعر تجاههما إيجابية وسلبية على التوالي.
يتم استخدام ABSA على نطاق واسع من قبل المؤسسات لاستخراج رؤى قيمة من خلال تحليل تعليقات العملاء تجاه جوانب المنتجات أو الخدمات في مختلف المجالات. ومع ذلك، فإن تصنيف بيانات التدريب لـ ABSA يعد مهمة شاقة بسبب الطبيعة الدقيقة (مستوى الرمز المميز) لتحديد الجوانب يدويًا داخل عينات التدريب.
إن Intel Labs وHugging Face متحمسان لتقديم SetFitABSA، وهو إطار عمل للتدريب على عدد قليل من نماذج ABSA الخاصة بالمجال؛ يعد SetFitABSA منافسًا ويتفوق في الأداء على النماذج التوليدية مثل Llama2 وT5 في سيناريوهات قليلة اللقطات.
بالمقارنة مع الأساليب المعتمدة على LLM، يتمتع SetFitABSA بميزتين فريدتين:
🗣 لا حاجة للمطالبات: يتطلب التعلم في سياق اللقطات القليلة باستخدام LLM مطالبات مصنوعة يدويًا مما يجعل النتائج هشة وحساسة للصياغة وتعتمد على خبرة المستخدم. يتخلص SetFitABSA من المطالبات تمامًا عن طريق إنشاء عمليات تضمين غنية مباشرة من عدد صغير من الأمثلة النصية ذات العلامات.
🏎 سريع في التدريب: لا يتطلب SetFitABSA سوى عدد قليل من عينات التدريب المصنفة؛ بالإضافة إلى ذلك، فهو يستخدم تنسيقًا بسيطًا لبيانات التدريب، مما يلغي الحاجة إلى أدوات وضع العلامات المتخصصة. وهذا يجعل عملية وضع العلامات على البيانات سريعة وسهلة.
في منشور المدونة هذا، سنشرح كيفية عمل SetFitABSA وكيفية تدريب النماذج الخاصة بك باستخدام مكتبة SetFit. دعونا الغوص في!
كيف يعمل؟
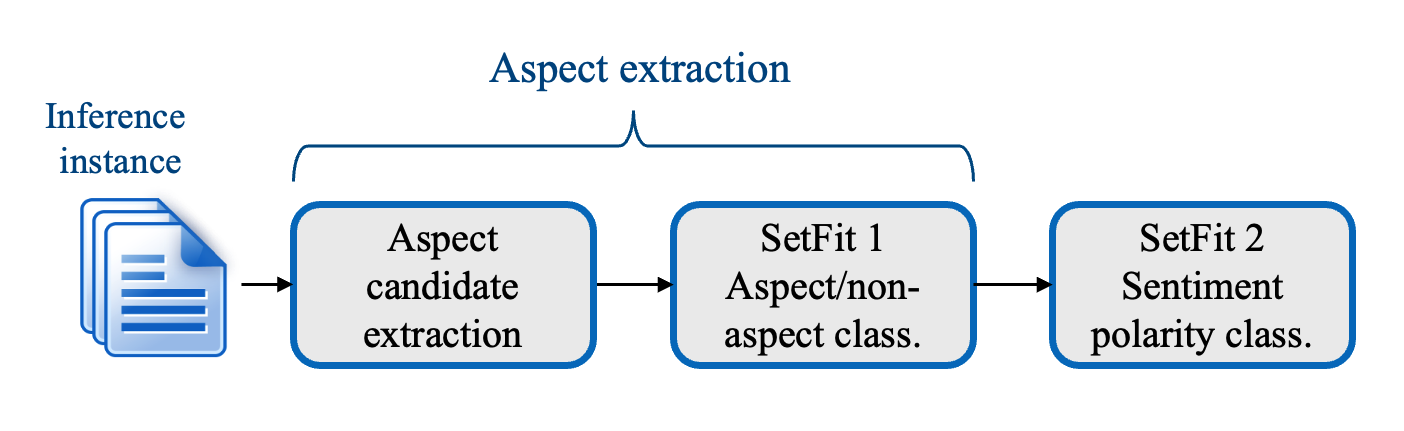
عملية تدريب SetFitABSA المكونة من ثلاث مراحل
يتكون SetFitABSA من ثلاث خطوات. تستخرج الخطوة الأولى مرشحات الجانب من النص، بينما تنتج الخطوة الثانية الجوانب عن طريق تصنيف مرشحات الجانب كجوانب أو غير جوانب، والخطوة الأخيرة تربط قطبية المشاعر بكل جانب مستخرج. تعتمد الخطوتان الثانية والثالثة على نماذج SetFit.
تمرين
1. الجانب استخراج المرشح
نفترض في هذا العمل أن الجوانب، التي عادة ما تكون ميزات المنتجات والخدمات، هي في الغالب أسماء أو مركبات اسمية (سلاسل من الأسماء المتتالية). نحن نستخدم spaCy لترميز واستخراج الأسماء/مركبات الأسماء من الجمل في مجموعة التدريب (القليلة). نظرًا لأن الأسماء/مركبات الأسماء المستخرجة ليست كلها جوانب، فإننا نشير إليها كمرشحين للجوانب.
2. تصنيف الجانب/غير الجانب
الآن بعد أن أصبح لدينا مرشحات للجوانب، نحتاج إلى تدريب نموذج حتى نتمكن من التمييز بين الأسماء التي هي جوانب والأسماء التي ليست جوانب. ولهذا الغرض، نحتاج إلى عينات تدريبية تحتوي على تسميات ذات جوانب/بدون جوانب. يتم ذلك من خلال النظر في الجوانب الموجودة في مجموعة التدريب مثل True الجوانب، في حين تعتبر الجوانب المرشحة الأخرى غير المتداخلة غير جوانب، وبالتالي يتم تصنيفها على أنها False:
- جملة التدريب: “النوادل ليسوا ودودين ولكن المعكرونة الكريمية خارج هذا العالم.”
- مُرمز: [Waiters, are, n’t, friendly, but, the, cream, pasta, is, out, of, this, world, .]
- المرشحين الجانب المستخرج: [Waiters, are, n’t, friendly, but, the, cream, pasta, is, out, of, this, world, .]
- الملصقات الذهبية من مجموعة التدريب بتنسيق BIO: [B-ASP, O, O, O, O, O, B-ASP, I-ASP, O, O, O, O, O, .]
- تسميات الجوانب/غير الجوانب التي تم إنشاؤها: [Waiters, are, n’t, friendly, but, the, cream, pasta, is, out, of, this, world, .]
الآن بعد أن تم تصنيف جميع الجوانب المرشحة، كيف يمكننا استخدامها لتدريب نموذج تصنيف جوانب المرشح؟ بمعنى آخر، كيف نستخدم SetFit، وهو إطار عمل لتصنيف الجمل، لتصنيف الرموز الفردية؟ حسنًا، هذه هي الحيلة: يتم ربط كل جانب مرشح مع جملة التدريب بأكملها لإنشاء مثيل تدريب باستخدام القالب التالي:
aspect_candidate:training_sentence
سيؤدي تطبيق القالب على المثال أعلاه إلى إنشاء 3 حالات تدريب – اثنتان منها True تسميات تمثل مثيلات التدريب الجانبي، وواحدة مع False التسمية التي تمثل مثيل التدريب غير الجانبي:
| نص | ملصق |
|---|---|
| النوادل: النوادل ليسوا ودودين ولكن المعكرونة الكريمية خارج هذا العالم. | 1 |
| المعكرونة الكريمية: النوادل ليسوا ودودين ولكن المعكرونة الكريمية خارج هذا العالم. | 1 |
| العالم: النوادل ليسوا ودودين ولكن المعكرونة الكريمية خارج هذا العالم. | 0 |
| … | … |
بعد إنشاء مثيلات التدريب، نحن على استعداد لاستخدام قوة SetFit لتدريب مصنف ثنائي خاص بالمجال لبضع لقطات لاستخراج الجوانب من مراجعة نص الإدخال. سيكون هذا أول نموذج SetFit تم ضبطه بدقة.
3. تصنيف قطبية المشاعر
بمجرد أن يستخرج النظام الجوانب من النص، فإنه يحتاج إلى ربط قطبية المشاعر (على سبيل المثال، إيجابية أو سلبية أو محايدة) بكل جانب. ولهذا الغرض، نستخدم نموذج SetFit الثاني وندربه بطريقة مشابهة لنموذج استخراج الجوانب كما هو موضح في المثال التالي:
- جملة التدريب: “النوادل ليسوا ودودين ولكن المعكرونة الكريمية خارج هذا العالم.”
- مُرمز: [Waiters, are, n’t, friendly, but, the, cream, pasta, is, out, of, this, world, .]
- الملصقات الذهبية من مجموعة التدريب: [NEG, O, O, O, O, O, POS, POS, O, O, O, O, O, .]
| نص | ملصق |
|---|---|
| النوادل: النوادل ليسوا ودودين ولكن المعكرونة الكريمية خارج هذا العالم. | نيج |
| المعكرونة الكريمية: النوادل ليسوا ودودين ولكن المعكرونة الكريمية خارج هذا العالم. | نقاط البيع |
| … | … |
لاحظ أنه على عكس نموذج استخراج الجوانب، فإننا لا نقوم بتضمين الجوانب غير في مجموعة التدريب هذه لأن الهدف هو تصنيف قطبية المشاعر تجاه الجوانب الحقيقية.
تشغيل الاستدلال
في وقت الاستدلال، تمر جملة الاختبار عبر مرحلة استخراج مرشح الجانب SpaCy، مما يؤدي إلى ظهور حالات اختبار باستخدام القالب aspect_candidate:test_sentence. بعد ذلك، تتم تصفية العناصر غير الجوانب بواسطة مُصنف الجوانب/غير الجوانب. وأخيرًا، يتم تغذية الجوانب المستخرجة إلى مصنف قطبية المشاعر الذي يتنبأ بقطبية المشاعر لكل جانب.
من الناحية العملية، هذا يعني أن النموذج يمكن أن يتلقى نصًا عاديًا كجوانب المدخلات والمخرجات ومشاعرها:
إدخال النموذج:
"their dinner specials are fantastic."
إخراج النموذج:
[{'span': 'dinner specials', 'polarity': 'positive'}]
قياس الأداء
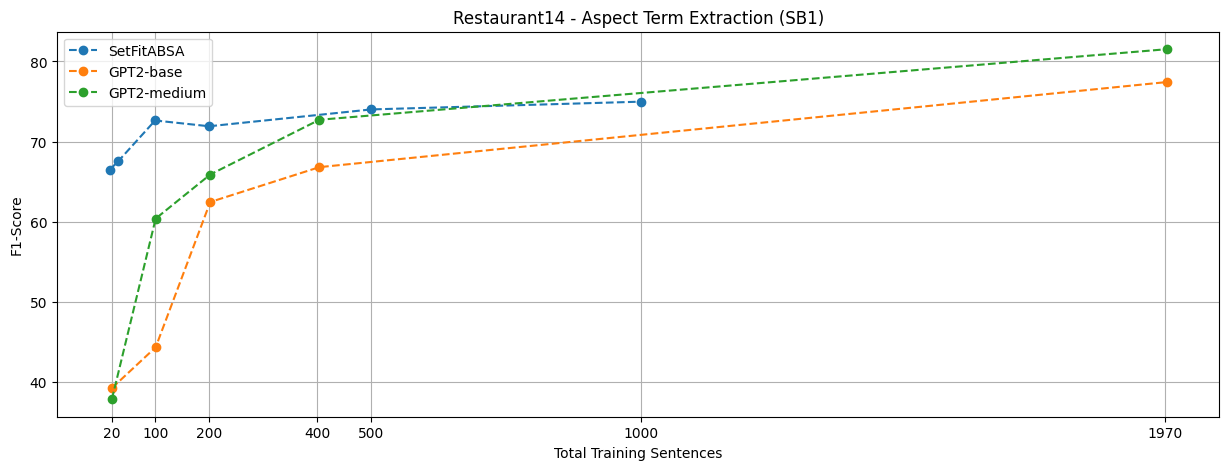
تم تقييم SetFitABSA مقابل أحدث الأعمال التي قامت بها AWS AI Labs وSalesforce AI Research التي تعمل على تحسين T5 وGPT2 باستخدام المطالبات. للحصول على صورة أكثر اكتمالاً، قمنا أيضًا بمقارنة نموذجنا بنموذج Llama-2-chat باستخدام التعلم في السياق. نحن نستخدم مجموعات بيانات Laptop14 وRestaurant14 ABSA الشهيرة من تحدي التقييم الدلالي 2014 (SemEval14). يتم تقييم SetFitABSA على حد سواء على المهمة المتوسطة لاستخراج مصطلح الجانب (SB1) وعلى مهمة ABSA الكاملة لاستخراج الجانب إلى جانب تنبؤات قطبية المشاعر (SB1 + SB2).
مقارنة حجم النموذج
| نموذج | الحجم (المعلمات) |
|---|---|
| اللاما-2-دردشة | 7 ب |
| قاعدة T5 | 220 م |
| قاعدة GPT2 | 124 م |
| GPT2 المتوسطة | 355 م |
| سيت فيت (MPNet) | 2 × 110 م |
لاحظ أنه بالنسبة لمهمة SB1، فإن SetFitABSA عبارة عن 110 مليون معلمة، وبالنسبة لـ SB2 فهي 110 مليون معلمة، وبالنسبة لـ SB1+SB2، يتكون SetFitABSA من 220 مليون معلمة.
مقارنة الأداء
نرى ميزة واضحة لـ SetFitABSA عندما يكون عدد مثيلات التدريب منخفضًا، على الرغم من كونه أصغر بمقدار 2x من T5 وأصغر بمقدار 3 مرات من GPT2-medium. حتى عند مقارنتها بـ Llama 2، وهي أكبر بمقدار x64، فإن الأداء يكون على قدم المساواة أو أفضل.
SetFitABSA vs GPT2
SetFitABSA vs T5
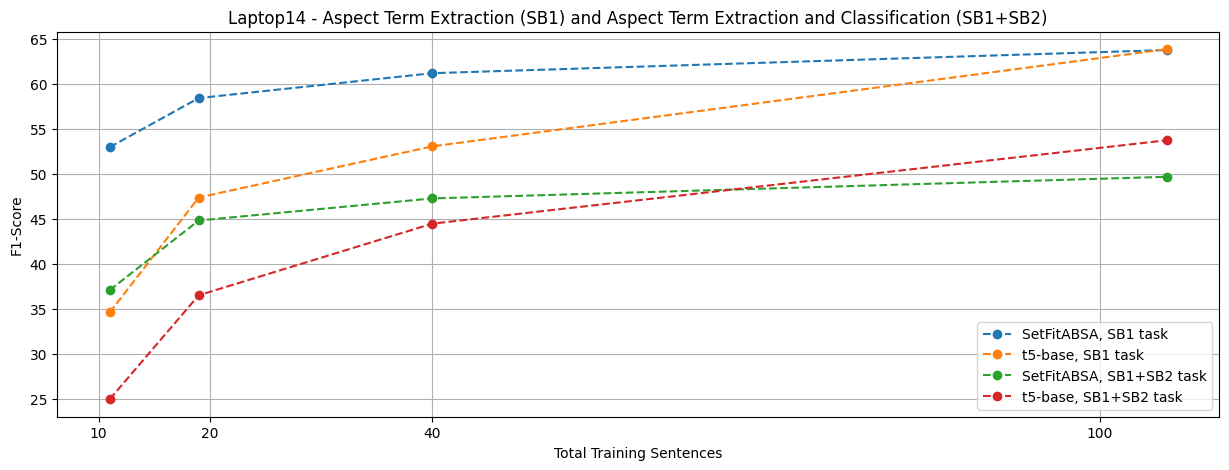
لاحظ أنه من أجل المقارنة العادلة، أجرينا مقارنات مع SetFitABSA مقابل تقسيمات مجموعة البيانات بالضبط المستخدمة بواسطة خطوط الأساس المختلفة (GPT2، T5، وما إلى ذلك).
SetFitABSA vs Llama2
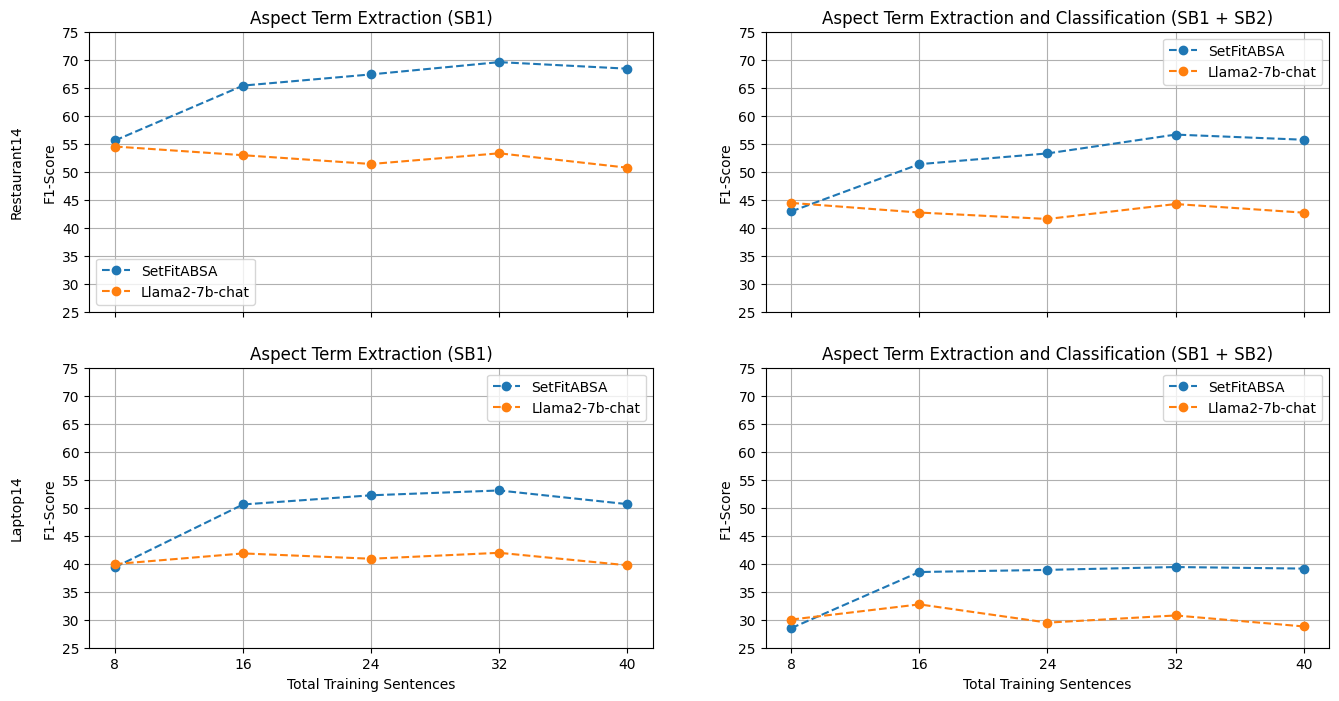
لقد لاحظنا أن زيادة عدد عينات التدريب داخل السياق لـ Llama2 لم يؤد إلى تحسين الأداء. لقد تم عرض هذه الظاهرة في ChatGPT من قبل، ونعتقد أنه يجب إجراء مزيد من التحقيق فيها.
تدريب النموذج الخاص بك
يعد SetFitABSA جزءًا من إطار عمل SetFit. لتدريب نموذج ABSA، ابدأ بالتثبيت setfit مع absa تم تمكين الخيار:
python -m pip install -U "setfit[absa]"
بالإضافة إلى ذلك، يجب علينا تثبيت en_core_web_lg نموذج سباسي:
python -m spacy download en_core_web_lg
نواصل إعداد مجموعة التدريب. شكل مجموعة التدريب هو Dataset مع الأعمدة text, span, label, ordinal:
- نص: الجملة الكاملة أو النص الذي يحتوي على الجوانب.
- فترة: جانب من الجملة الكاملة. يمكن أن تكون كلمات متعددة. على سبيل المثال: “الطعام”.
- ملصق: التسمية (القطبية) المقابلة لنطاق العرض. على سبيل المثال: “إيجابي”. يمكن اختيار أسماء التصنيفات بشكل تعسفي عند وضع علامات على بيانات التدريب المجمعة.
- ترتيبي: إذا حدث امتداد العرض عدة مرات في النص، فإن هذا الترتيب يمثل فهرس تلك التكرارات. غالبًا ما يكون هذا 0 فقط، حيث يظهر كل جانب عادةً مرة واحدة فقط في نص الإدخال.
على سبيل المثال، النص التدريبي “مطعم يقدم طعامًا رائعًا ولكن أسوأ خدمة رأيتها على الإطلاق” يحتوي على جانبين، لذلك سيتم إضافة سطرين إلى جدول مجموعة التدريب:
| نص | فترة | ملصق | ترتيبي |
|---|---|---|---|
| مطعم يقدم طعامًا رائعًا ولكن أسوأ خدمة رأيتها على الإطلاق | طعام | إيجابي | 0 |
| مطعم يقدم طعامًا رائعًا ولكن أسوأ خدمة رأيتها على الإطلاق | خدمة | سلبي | 0 |
| … | … | … | … |
بمجرد أن تصبح مجموعة بيانات التدريب جاهزة، يمكننا إنشاء مدرب ABSA وتنفيذ التدريب. تعتبر نماذج SetFit فعالة إلى حد ما في التدريب، ولكن نظرًا لأن SetFitABSA يتضمن نموذجين تم تدريبهما بشكل تسلسلي، فمن المستحسن استخدام وحدة معالجة الرسومات للتدريب للحفاظ على وقت التدريب منخفضًا. على سبيل المثال، يقوم البرنامج النصي التدريبي التالي بتدريب نموذج SetFitABSA الكامل في حوالي 10 دقائق باستخدام وحدة معالجة الرسومات Google Colab T4 المجانية.
from datasets import load_dataset
from setfit import AbsaTrainer, AbsaModel


train_dataset = load_dataset("tomaarsen/setfit-absa-semeval-restaurants", split="train[:128]")


model = AbsaModel.from_pretrained("sentence-transformers/paraphrase-mpnet-base-v2")


trainer = AbsaTrainer(model, train_dataset=train_dataset)

trainer.train()
هذا كل شيء! لقد قمنا بتدريب نموذج ABSA خاص بالمجال. يمكننا حفظ نموذجنا المدرب على القرص أو تحميله على مركز Hugging Face. مع الأخذ في الاعتبار أن النموذج يحتوي على نموذجين فرعيين، بحيث يتم إعطاء كل منهما مساره الخاص:
model.save_pretrained(
    "models/setfit-absa-model-aspect",
    "models/setfit-absa-model-polarity"
)

model.push_to_hub(
    "tomaarsen/setfit-absa-paraphrase-mpnet-base-v2-restaurants-aspect",
    "tomaarsen/setfit-absa-paraphrase-mpnet-base-v2-restaurants-polarity"
)
الآن يمكننا استخدام نموذجنا المدرب للاستدلال. نبدأ بتحميل النموذج:
from setfit import AbsaModel

model = AbsaModel.from_pretrained(
    "tomaarsen/setfit-absa-paraphrase-mpnet-base-v2-restaurants-aspect",
    "tomaarsen/setfit-absa-paraphrase-mpnet-base-v2-restaurants-polarity"
)
ثم نستخدم واجهة برمجة التطبيقات المتوقعة لتشغيل الاستدلال. الإدخال عبارة عن قائمة من السلاسل، يمثل كل منها مراجعة نصية:
preds = model.predict([
    "Best pizza outside of Italy and really tasty.",
    "The food variations are great and the prices are absolutely fair.",
    "Unfortunately, you have to expect some waiting time and get a note with a waiting number if it should be very full."
])

print(preds)
لمزيد من التفاصيل حول خيارات التدريب وحفظ النماذج وتحميلها والاستدلال، راجع مستندات SetFit.
مراجع
- ماريا بونتيكي، وديميتريس جالانيس، وجون بافلوبولوس، وهاريس باباجورجيو، وإيون أندروتسوبولوس، وسوريش ماناندهار. 2014. SemEval-2014 المهمة 4: تحليل المشاعر على أساس الجانب. في وقائع ورشة العمل الدولية الثامنة حول التقييم الدلالي (SemEval 2014)، الصفحات 27-35.
- سيدهارث فاريا، شواي وانغ، كيشالوي هالدر، روبرت فاكاريانو، ميغيل باليستيروس، ياسين بنجيبة، نيها آنا جون، ريشيتا أنوبهاي، سماراندا موريسان، دان روث، 2023 “ضبط التعليمات لتحليل المشاعر على أساس جوانب قليلة”. https://arxiv.org/abs/2210.06629
- إحسان حسيني-أسل، وينهاو ليو، كايمينغ شيونغ، 2022. “نموذج لغة توليدي لتحليل المشاعر على أساس الجوانب القليلة”. https://arxiv.org/abs/2204.05356
- لويس تونستول، نيلز رايمرز، أونسو أون سيو جو، لوك بيتس، دانييل كورات، موشيه فاسربلات، أورين بيريغ، 2022. “التعلم الفعال بدون مطالبات”. https://arxiv.org/abs/2209.11055
