

يعد SetFit حلاً واعدًا لمشكلة النمذجة الشائعة: كيفية التعامل مع نقص البيانات المصنفة للتدريب. تم تطوير SetFit بالتعاون مع شركاء Hugging Face البحثيين في Intel Labs وUKP Lab، وهو إطار عمل فعال لضبط نماذج Sentence Transformers في لقطات قليلة.
يحقق SetFit دقة عالية مع القليل من البيانات المُصنفة – على سبيل المثال، يتفوق SetFit على GPT-3.5 في المطالبة بثلاث طلقات ومع 5 طلقات يتفوق أيضًا على GPT-4 ذو 3 طلقات في مجموعة بيانات النية المالية Banking 77.
بالمقارنة مع الأساليب المعتمدة على LLM، يتمتع SetFit بميزتين فريدتين:
🗣 لا توجد مطالبات أو لفظية: يتطلب التعلم في سياق اللقطات القليلة باستخدام LLMs مطالبات مصنوعة يدويًا مما يجعل النتائج هشة وحساسة للصياغة وتعتمد على خبرة المستخدم. يتخلص SetFit من المطالبات تمامًا عن طريق إنشاء عمليات تضمين غنية مباشرة من عدد صغير من الأمثلة النصية ذات العلامات.
🏎 سريع في التدريب: لا يعتمد SetFit على شهادات LLM مثل GPT-3.5 أو Llama2 لتحقيق الدقة العالية. ونتيجة لذلك، عادةً ما يكون التدريب على الاستدلال وتشغيله أسرع بدرجة كبيرة (أو أكثر).
لمزيد من التفاصيل حول SetFit، راجع بحثنا ومدونتنا وأكوادنا وبياناتنا.
تم اعتماد Setfit على نطاق واسع من قبل مجتمع مطوري الذكاء الاصطناعي، مع ما يقرب من 100 ألف عملية تنزيل شهريًا وحوالي 1500 نموذج SetFit على المركز، وتنمو بمعدل 4 نماذج تقريبًا يوميًا!
أسرع!
في منشور المدونة هذا، سنشرح كيف يمكنك تسريع الاستدلال باستخدام SetFit 7.8x على وحدات المعالجة المركزية Intel، من خلال تحسين طراز SetFit الخاص بك باستخدام 🤗 Optimum Intel. سنوضح كيف يمكنك تحقيق مكاسب هائلة في الإنتاجية من خلال تنفيذ خطوة تكميم بسيطة بعد التدريب على النموذج الخاص بك. يمكن أن يؤدي ذلك إلى تمكين نشر حلول SetFit على مستوى الإنتاج باستخدام وحدات المعالجة المركزية Intel Xeon.
Optimum Intel هي مكتبة مفتوحة المصدر تعمل على تسريع خطوط الأنابيب الشاملة المبنية باستخدام مكتبات Hugging Face على أجهزة Intel. يتضمن Optimum Intel العديد من التقنيات لتسريع النماذج مثل تكميم البت المنخفض، وتقليص وزن النموذج، والتقطير، ووقت التشغيل المتسارع.
يستفيد وقت التشغيل والتحسينات المضمنة في Optimum Intel من Intel® Advanced Vector Extensions 512 (Intel® AVX-512)، وتعليمات الشبكة العصبية الموجهة (VNNI) وIntel® Advanced Matrix Extensions (Intel® AMX) على وحدات المعالجة المركزية Intel لتسريع النماذج. على وجه التحديد، يحتوي على مسرعات BFloat16 (bf16) وint8 GEMM مدمجة في كل مركز لتسريع التدريب على التعلم العميق واستدلال أعباء العمل. يتم تقديم الاستدلال المتسارع AMX في PyTorch 2.0 وIntel Extension for PyTorch (IPEX) بالإضافة إلى تحسينات أخرى لمختلف المشغلين المشتركين.
يمكن تحسين النماذج المدربة مسبقًا بسهولة باستخدام Optimum Intel؛ يمكن العثور على العديد من الأمثلة البسيطة هنا. مدونتنا مصحوبة بدفتر ملاحظات للإرشادات التفصيلية خطوة بخطوة.
الخطوة 1: قم بقياس نموذج SetFit باستخدام 🤗 Optimum Intel
من أجل تحسين نموذج SetFit الخاص بنا، سنطبق التكميم على جسم النموذج، باستخدام Intel Neural Compressor (INC)، وهو جزء من Optimum Intel.
التكميم هي تقنية شائعة جدًا لتحسين نماذج التعلم العميق لتحسين سرعات الاستدلال. فهو يقلل من عدد البتات المطلوبة لتمثيل الأوزان و/أو عمليات التنشيط في الشبكة العصبية. ويتم ذلك عن طريق تحويل مجموعة من الأرقام عالية الدقة إلى تمثيلات بيانات ذات بت أقل، مثل INT8. علاوة على ذلك، يمكن للتكميم أن يتيح إجراء حسابات أسرع وبدقة أقل.
على وجه التحديد، سوف نطبق التكميم الثابت بعد التدريب (PTQ). يمكن لـ PTQ تقليل أثر الذاكرة وزمن الوصول للاستدلال، مع الحفاظ على دقة النموذج، مع مجموعة معايرة صغيرة غير مسماة فقط وبدون أي تدريب. قبل أن تبدأ، تأكد من تثبيت جميع المكتبات الضرورية وأن إصدار Optimum Intel لديك على الأقل 1.14.0 منذ أن تم تقديم الوظيفة في هذا الإصدار:
pip install --upgrade-strategy eager optimum[ipex]
إعداد مجموعة بيانات المعايرة
يجب أن تكون مجموعة بيانات المعايرة قادرة على تمثيل توزيع البيانات غير المرئية. بشكل عام، يعد تحضير 100 عينة كافيًا للمعايرة. سوف نستخدم rotten_tomatoes مجموعة البيانات في حالتنا، نظرًا لأنها تتكون من مراجعات للأفلام، على غرار مجموعة البيانات المستهدفة لدينا، sst2.
أولاً، سنقوم بتحميل 100 عينة عشوائية من مجموعة البيانات هذه. وبعد ذلك، لإعداد مجموعة البيانات للتكميم، سنحتاج إلى ترميز كل مثال. لن نحتاج إلى أعمدة “النص” و”التسمية”، لذا فلنقم بإزالتها.
calibration_set = load_dataset("rotten_tomatoes", split="train").shuffle(seed=42).select(range(100))

def tokenize(examples):
    return tokenizer(examples["text"], padding="max_length", max_length=512, truncation=True)

tokenizer = setfit_model.model_body.tokenizer
calibration_set = calibration_set.map(tokenize, remove_columns=["text", "label"])
تشغيل التكميم
قبل أن نقوم بعملية التكميم، نحتاج إلى تحديد عملية التكميم المطلوبة – في حالتنا – ثابت بعد التدريب الكمي، واستخدام optimum.intel لتشغيل القياس الكمي على مجموعة بيانات المعايرة لدينا:
from optimum.intel import INCQuantizer
from neural_compressor.config import PostTrainingQuantConfig

setfit_body = setfit_model.model_body[0].auto_model
quantizer = INCQuantizer.from_pretrained(setfit_body)
optimum_model_path = "/tmp/bge-small-en-v1.5_setfit-sst2-english_opt"
quantization_config = PostTrainingQuantConfig(approach="static", backend="ipex", domain="nlp")

quantizer.quantize(
    quantization_config=quantization_config,
    calibration_dataset=calibration_set,
    save_directory=optimum_model_path,
    batch_size=1,
)
tokenizer.save_pretrained(optimum_model_path)
هذا كل شيء! لدينا الآن نسخة محلية من نموذج SetFit الكمي. دعونا نختبر ذلك.
الخطوة 2: الاستدلال المعياري
في دفتر ملاحظاتنا، قمنا بإعداد PerformanceBenchmark فئة لحساب زمن الوصول والإنتاجية للنموذج، بالإضافة إلى قياس الدقة. دعنا نستخدمها لقياس نموذج Intel الأمثل لدينا من خلال طريقتين أخريين شائعتين الاستخدام:
- استخدام PyTorch و 🤗 مكتبة Transformers مع fp32.
- استخدام Intel Extension for PyTorch (IPEX) لوقت التشغيل مع bf16 وتتبع النموذج باستخدام TorchScript.
قم بتحميل مجموعة بيانات الاختبار الخاصة بنا، sst2، وقم بتشغيل الاختبار باستخدام PyTorch و 🤗 مكتبة Transformers:
from datasets import load_dataset
from setfit import SetFitModel
test_dataset = load_dataset("SetFit/sst2")["validation"]

model_path = "dkorat/bge-small-en-v1.5_setfit-sst2-english"
setfit_model = SetFitModel.from_pretrained(model_path)
pb = PerformanceBenchmark(
    model=setfit_model,
    dataset=test_dataset,
    optim_type="bge-small (transformers)",
)
perf_metrics = pb.run_benchmark()
بالنسبة للمعيار الثاني، سنستخدم Intel Extension for PyTorch (IPEX) بدقة bf16 وتتبع TorchScript. لاستخدام IPEX، نقوم ببساطة باستيراد مكتبة IPEX وتطبيقها ipex.optimize() إلى النموذج المستهدف، والذي، في حالتنا، هو جسم نموذج SetFit (المحول):
dtype = torch.bfloat16
body = ipex.optimize(setfit_model.model_body, dtype=dtype)
بالنسبة لتتبع TorchScript، نقوم بإنشاء تسلسل عشوائي استنادًا إلى الحد الأقصى لطول إدخال النموذج، مع أخذ عينات من الرموز المميزة من مفردات أداة الرمز المميز:
tokenizer = setfit_model.model_body.tokenizer
d = generate_random_sequences(batch_size=1, length=tokenizer.model_max_length, vocab_size=tokenizer.vocab_size)

body = torch.jit.trace(body, (d,), check_trace=False, strict=False)
setfit_model.model_body = torch.jit.freeze(body)
لنقم الآن بتشغيل المعيار باستخدام نموذجنا الأمثل الكمي. سنحتاج أولاً إلى تحديد غلاف حول نموذج SetFit الخاص بنا والذي يتم توصيله بجسم النموذج الكمي الخاص بنا عند الاستدلال (بدلاً من جسم النموذج الأصلي). وبعد ذلك، يمكننا تشغيل المعيار باستخدام هذا المجمع.
from optimum.intel import IPEXModel

class OptimumSetFitModel:
    def __init__(self, setfit_model, model_body):
        model_body.tokenizer = setfit_model.model_body.tokenizer
        self.model_body = model_body
        self.model_head = setfit_model.model_head


optimum_model = IPEXModel.from_pretrained(optimum_model_path)
optimum_setfit_model = OptimumSetFitModel(setfit_model, model_body=optimum_model)

pb = PerformanceBenchmark(
    model=optimum_setfit_model,
    dataset=test_dataset,
    optim_type=f"bge-small (optimum-int8)",
    model_path=optimum_model_path,
    autocast_dtype=torch.bfloat16,
)
perf_metrics.update(pb.run_benchmark())
نتائج
الدقة مقابل الكمون عند حجم الدفعة = 1
| bge-small (المحولات) | bge-صغير (ipex-bfloat16) | bge-صغير (الأمثل-int8) | |
|---|---|---|---|
| حجم النموذج | 127.32 ميجابايت | 63.74 ميجابايت | 44.65 ميجابايت |
| الدقة في مجموعة الاختبار | 88.4% | 88.4% | 88.1% |
| الكمون (BS=1) | 15.69 +/- 0.57 مللي ثانية | 5.67 +/- 0.66 مللي ثانية | 4.55 +/- 0.25 مللي ثانية |
عند فحص الأداء بحجم الدفعة 1، هناك أ تقليل زمن الوصول بمقدار 3.45 مرة مع نموذجنا الأمثل. لاحظ أن هذا يتم تحقيقه دون أي انخفاض في الدقة تقريبًا! ومن الجدير بالذكر أيضًا أن حجم النموذج قد تقلص 2.85x.
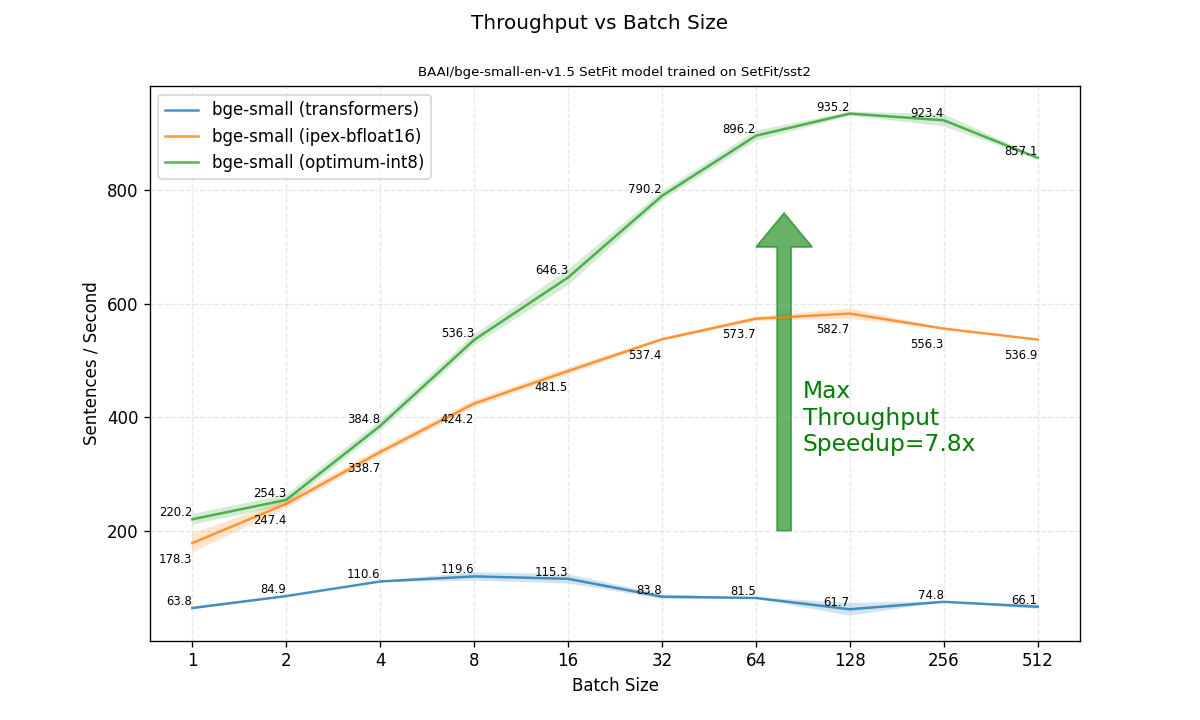
ننتقل إلى تركيزنا الرئيسي، وهو الإنتاجية المبلغ عنها بأحجام دفعات مختلفة. هنا، حصل التحسين على سرعات أكبر. عند مقارنة أعلى إنتاجية يمكن تحقيقها (بأي حجم دفعة)، فإن النموذج الأمثل هو أسرع بـ 7.8 مرات من طراز المحولات الأصلية FP32!
ملخص
في منشور المدونة هذا، أظهرنا كيفية استخدام إمكانات التكميم الموجودة في 🤗 Optimum Intel لتحسين نماذج SetFit. بعد تنفيذ إجراء سريع وسهل للتكميم بعد التدريب، لاحظنا أنه تم الحفاظ على مستوى الدقة، في حين زاد إنتاجية الاستدلال بمقدار 7.8x. يمكن تطبيق طريقة التحسين هذه بسهولة على أي نشر SetFit موجود يعمل على Intel Xeon.
مراجع
- لويس تونستول، نيلز رايمرز، أونسو أون سيو جو، لوك بيتس، دانييل كورات، موشيه فاسربلات، أورين بيريغ، 2022. “التعلم الفعال بدون مطالبات”. https://arxiv.org/abs/2209.11055
