

نحن متحمسون لإصدار Idefics2، وهو نموذج عام متعدد الوسائط يأخذ تسلسلات عشوائية من النصوص والصور كمدخلات، ويولد استجابات نصية. يمكنه الإجابة على أسئلة حول الصور، ووصف المحتوى المرئي، وإنشاء قصص مستندة إلى صور متعددة، واستخراج المعلومات من المستندات، وتنفيذ العمليات الحسابية الأساسية.
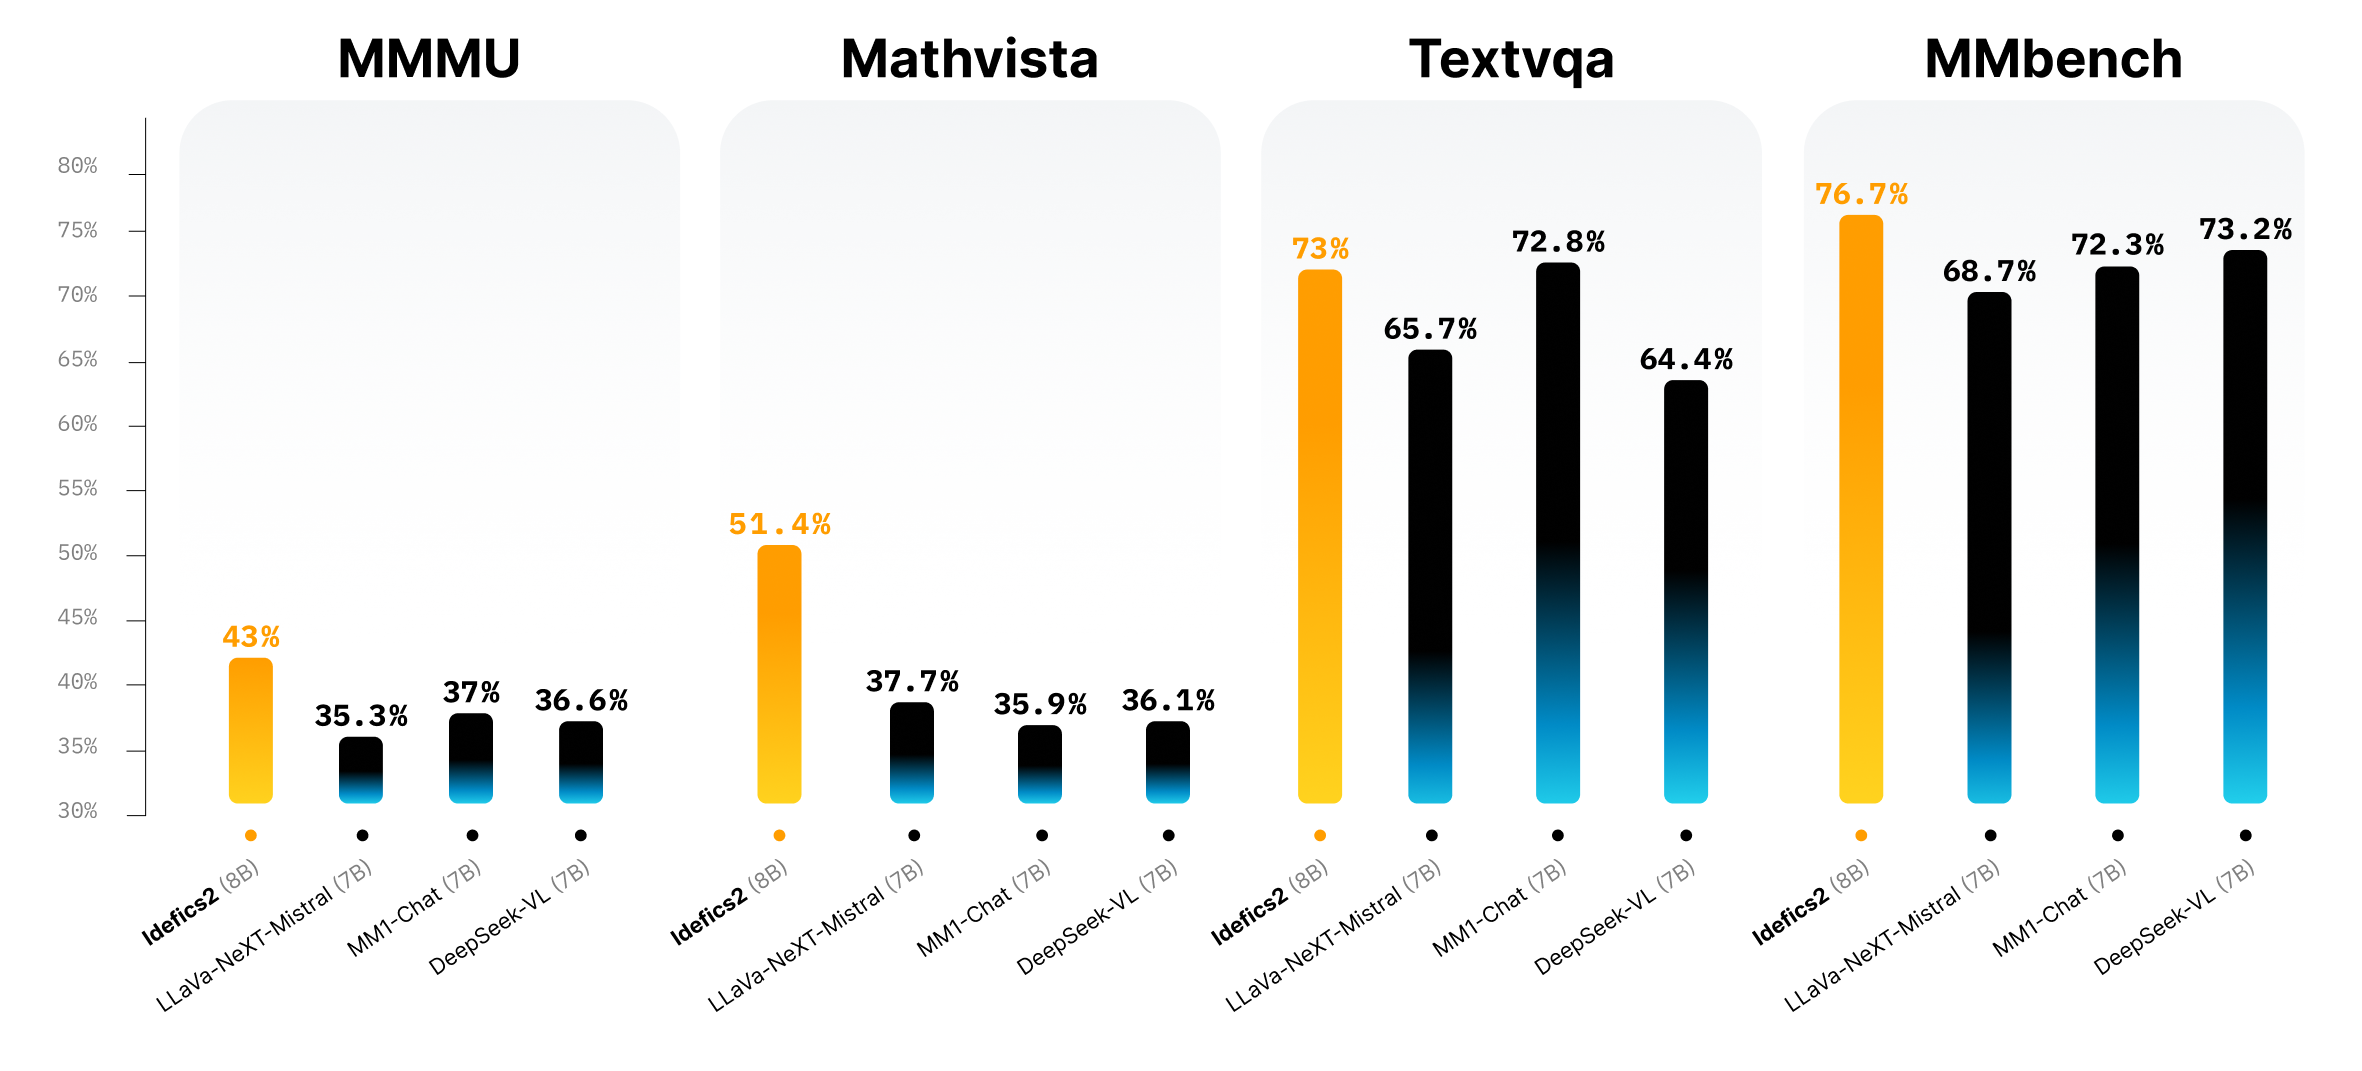
يتحسن Idefics2 على Idefics1: مع معلمات 8B، والترخيص المفتوح (Apache 2.0)، وقدرات OCR (التعرف البصري على الأحرف) المحسنة، يعد Idefics2 أساسًا قويًا للمجتمع الذي يعمل على الوسائط المتعددة. يعد أدائه في معايير الإجابة على الأسئلة المرئية أعلى من حجم فئته، ويتنافس مع نماذج أكبر بكثير مثل LLava-Next-34B وMM1-30B-chat.
تم دمج Idefics2 أيضًا في 🤗 Transformers منذ البداية، وبالتالي يسهل ضبطه للعديد من التطبيقات متعددة الوسائط. يمكنك تجربة النماذج الموجودة على Hub الآن!
الأوزان |
لكل صورة |
(فال / اختبار) |
(تستميني) |
(فال) |
(امتحان) |
(اختبار التطوير) |
(امتحان) |
||
|---|---|---|---|---|---|---|---|---|---|
| ديب سيك-VL | ✅ | 7 ب | 576 | 36.6/- | 36.1 | 64.4 | 73.2 | – | 49.6 |
| LLaVa-NeXT-ميسترال-7B | ✅ | 7 ب | 2880 | 35.3/- | 37.7 | 65.7 | 68.7 | 82.2 | – |
| لافا-نيكست-13بي | ✅ | 13 ب | 2880 | 36.2/- | 35.3 | 67.1 | 70.0 | 82.8 | – |
| لافا-نيكست-34ب | ✅ | 34 ب | 2880 | 51.1/44.7 | 46.5 | 69.5 | 79.3 | 83.7 | – |
| MM1-دردشة-7B | ❌ | 7 ب | 720 | 37.0/35.6 | 35.9 | 72.8 | 72.3 | 82.8 | – |
| MM1-دردشة-30B | ❌ | 30 ب | 720 | 44.7/40.3 | 39.4 | 73.5 | 75.1 | 83.7 | |
| الجوزاء 1.0 برو | ❌ | 🤷♂️ | 🤷♂️ | 47.9/- | 45.2 | 74.6 | – | 71.2 | 88.1 |
| الجوزاء 1.5 برو | ❌ | 🤷♂️ | 🤷♂️ | 58.5/- | 52.1 | 73.5 | – | 73.2 | 86.5 |
| كلود 3 هايكو | ❌ | 🤷♂️ | 🤷♂️ | 50.2/- | 46.4 | – | – | – | 88.8 |
| تعليمات Idefics1 (32 طلقة) | ✅ | 80 ب | – | – | – | 39.3 | – | 68.8 | – |
| تعريف2 (بدون im.split)* | ✅ | 8 ب | 64 | 43.5/37.9 | 51.6 | 70.4 | 76.8 | 80.8 | 67.3 |
| تعريف2 (ث / ايم.سبليت)* | ✅ | 8 ب | 320 | 43.0/37.7 | 51.4 | 73.0 | 76.7 | 81.2 | 74.0 |
* ث / ايم. التقسيم: باتباع إستراتيجية SPHINX وLLaVa-NeXT، نسمح بتقسيم الصور الفرعية بشكل اختياري إلى 4.
بيانات التدريب
تم تدريب Idefics2 على مزيج من مجموعات البيانات المتاحة بشكل مفتوح للتدريب المسبق: مستندات الويب المتداخلة (Wikipedia وOBELICS)، وأزواج التسميات التوضيحية للصور (Public Multimodal Dataset، LAION-COCO)، وبيانات التعرف الضوئي على الحروف (PDFA (en)، وIDL والنص المقدم، وبيانات الصورة إلى رمز (WebSight)).
يسمح التصور التفاعلي باستكشاف مجموعة بيانات OBELICS.
باتباع الممارسات الشائعة في مجتمع النماذج الأساسية، نقوم بتدريب النموذج الأساسي بشكل أكبر على البيانات الموجهة نحو المهام. ومع ذلك، غالبًا ما تكون هذه البيانات بتنسيقات متباينة ومتناثرة في أماكن مختلفة. فجمعهم عائق أمام المجتمع. لمعالجة هذه المشكلة، قمنا بإصدار مجموعة بيانات الضبط الدقيق للتعليمات متعددة الوسائط التي قمنا بإعدادها: المرجل، تجميع مفتوح لـ 50 مجموعات البيانات المنسقة يدويًا والمنسقة للمحادثات متعددة المنعطفات. نقوم بتعليم Idefics2 المضبوط بدقة بشأن تسلسل The Cauldron والعديد من مجموعات بيانات الضبط الدقيق للتعليمات النصية فقط.
تحسينات على Idefics1
- نحن نتعامل مع الصور بدقة أصلية (تصل إلى 980 × 980) ونسب العرض إلى الارتفاع الأصلية باتباع إستراتيجية NaViT. وهذا يتجنب الحاجة إلى تغيير حجم الصور إلى مربعات ذات حجم ثابت كما حدث تاريخيًا في مجتمع الرؤية الحاسوبية. بالإضافة إلى ذلك، نحن نتبع إستراتيجية SPHINX ونسمح (اختياريًا) بتقسيم الصور الفرعية وتمرير الصور ذات الدقة الكبيرة جدًا.
- لقد قمنا بتعزيز قدرات التعرف الضوئي على الحروف (OCR) بشكل كبير من خلال دمج البيانات التي تتطلب من النموذج نسخ النص في صورة أو مستند. قمنا أيضًا بتحسين القدرات في الإجابة على الأسئلة المتعلقة بالرسوم البيانية والأشكال والمستندات باستخدام بيانات التدريب المناسبة.
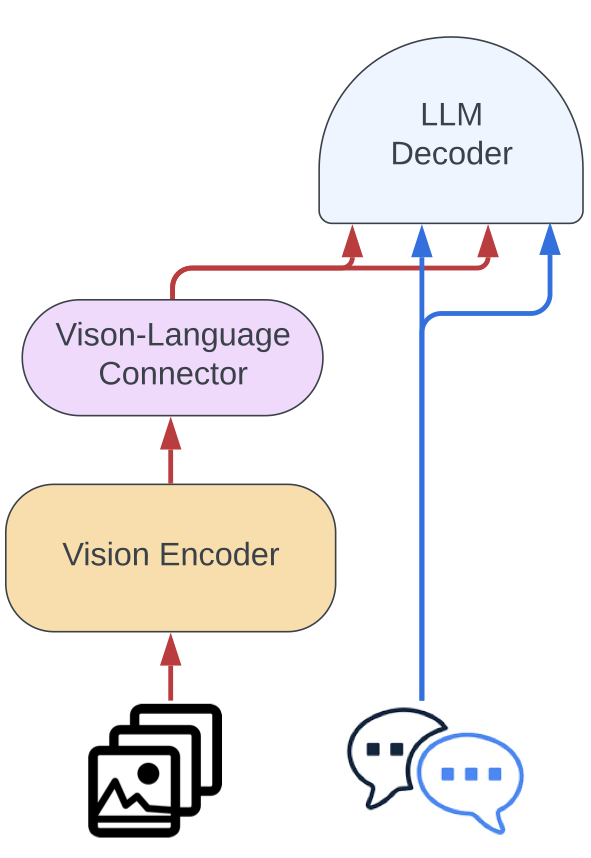
- لقد ابتعدنا عن بنية Idefics1 (الانتباه المتقاطع المسور) وقمنا بتبسيط دمج الميزات المرئية في العمود الفقري للغة. يتم تغذية الصور إلى برنامج تشفير الرؤية متبوعًا بتجميع المتلقي المتعلم وإسقاط طريقة MLP. يتم بعد ذلك ربط هذا التسلسل المجمع مع تضمينات النص للحصول على تسلسل (مشذر) من الصورة (الصور) والنص (النصوص).
كل هذه التحسينات جنبًا إلى جنب مع العناصر الأساسية المدربة مسبقًا بشكل أفضل تؤدي إلى قفزة كبيرة في الأداء مقارنةً بـ Idefics1 لنموذج أصغر بـ 10 مرات.
الشروع في العمل مع Idefics2
يتوفر Idefics2 على Hugging Face Hub وهو مدعوم في الإصدار الأخير transformers إصدار. فيما يلي نموذج التعليمات البرمجية لتجربته:
import requests
import torch
from PIL import Image

from transformers import AutoProcessor, AutoModelForVision2Seq
from transformers.image_utils import load_image

DEVICE = "cuda:0"


image1 = load_image("https://cdn.britannica.com/61/93061-050-99147DCE/Statue-of-Liberty-Island-New-York-Bay.jpg")
image2 = load_image("https://cdn.britannica.com/59/94459-050-DBA42467/Skyline-Chicago.jpg")
image3 = load_image("https://cdn.britannica.com/68/170868-050-8DDE8263/Golden-Gate-Bridge-San-Francisco.jpg")


processor = AutoProcessor.from_pretrained("HuggingFaceM4/idefics2-8b")
model = AutoModelForVision2Seq.from_pretrained(
    "HuggingFaceM4/idefics2-8b",
).to(DEVICE)


messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": "What do we see in this image?"},
        ]
    },
    {
        "role": "assistant",
        "content": [
            {"type": "text", "text": "In this image, we can see the city of New York, and more specifically the Statue of Liberty."},
        ]
    },
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": "And how about this image?"},
        ]
    },
]
prompt = processor.apply_chat_template(messages, add_generation_prompt=True)
inputs = processor(text=prompt, images=[image1, image2], return_tensors="pt")
inputs = {k: v.to(DEVICE) for k, v in inputs.items()}


generated_ids = model.generate(**inputs, max_new_tokens=500)
generated_texts = processor.batch_decode(generated_ids, skip_special_tokens=True)

print(generated_texts)
نحن نقدم أيضًا أداة ضبط دقيقة والتي يجب أن تكون مفيدة لأي شخص يتطلع إلى تحسين Idefics2 في حالات استخدام محددة.
موارد
إذا كنت ترغب في التعمق أكثر، فإليك تجميع كافة الموارد الخاصة بـ Idefics2:
رخصة
تم بناء النموذج على نموذجين مدربين مسبقًا: Mistral-7B-v0.1 وsiglip-so400m-patch14-384. تم إصدار كلاهما بموجب ترخيص Apache-2.0. نقوم بإصدار أوزان Idefics2 بموجب ترخيص Apache-2.0 أيضًا.
شكر وتقدير
شكرًا لفريق Google وMistral AI على إطلاق نماذجهم وإتاحتها لمجتمع الذكاء الاصطناعي مفتوح المصدر!
شكر خاص لـ Chun Te Lee على القصة، وMerve Noyan على المراجعة والاقتراحات بشأن منشور المدونة 🤗
