

في وقت سابق من هذا العام، أعلنت AMD وHugging Face عن شراكة لتسريع نماذج الذكاء الاصطناعي خلال حدث AMD’s AI Day. لقد بذلنا جهدًا كبيرًا لتحقيق هذه الرؤية، وتسهيل الأمر على مجتمع Hugging Face لتشغيل أحدث نماذج الذكاء الاصطناعي على أجهزة AMD بأفضل أداء ممكن.
تعمل AMD على تشغيل بعض أقوى أجهزة الكمبيوتر العملاقة في العالم، بما في ذلك أسرع جهاز أوروبي، LUMI، الذي يشغل أكثر من 10000 وحدة معالجة رسوميات MI250X AMD. في هذا الحدث، كشفت AMD عن أحدث جيل من وحدات معالجة الرسومات الخاصة بالخادم، وهي سلسلة مسرعات AMD Instinct™ MI300، والتي ستصبح متاحة للجميع قريبًا.
في منشور المدونة هذا، نقدم تحديثًا عن التقدم الذي أحرزناه نحو توفير دعم رائع خارج الصندوق لوحدات معالجة الرسومات AMD، وتحسين إمكانية التشغيل البيني لأحدث وحدات معالجة الرسومات AMD Instinct على مستوى الخادم
تسريع خارج الصندوق
هل يمكنك اكتشاف تغييرات التعليمات البرمجية الخاصة بـ AMD أدناه؟ لا تؤذي عينيك، لا يوجد شيء يضاهي العمل على وحدات معالجة الرسومات NVIDIA 🤗.
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

model_id = "01-ai/Yi-6B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
with torch.device("cuda"):
    model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype=torch.float16)

inp = tokenizer(["Today I am in Paris and"], padding=True, return_tensors="pt").to("cuda")
res = model.generate(**inp, max_new_tokens=30)

print(tokenizer.batch_decode(res))
أحد الجوانب الرئيسية التي عملنا عليها هو القدرة على تشغيل نماذج Hugging Face Transformers دون أي تغيير في التعليمات البرمجية. نحن ندعم الآن جميع نماذج ومهام Transformers على وحدات معالجة الرسوميات AMD Instinct. ولا يتوقف تعاوننا هنا، حيث نستكشف الدعم الجاهز لنماذج الناشرات والمكتبات الأخرى بالإضافة إلى وحدات معالجة الرسومات AMD الأخرى.
لقد كان تحقيق هذا الإنجاز بمثابة جهد كبير وتعاون بين فرقنا وشركاتنا. للحفاظ على الدعم والأداء لمجتمع Hugging Face، قمنا ببناء اختبار متكامل لمكتبات Hugging Face مفتوحة المصدر على وحدات معالجة الرسوميات AMD Instinct في مراكز البيانات لدينا – وتمكنا من تقليل تأثير الكربون لأحمال العمل الجديدة هذه من خلال العمل مع Verne Global لنشر خوادم AMD Instinct في أيسلندا.
علاوة على الدعم الأصلي، هناك جانب رئيسي آخر لتعاوننا وهو توفير التكامل لأحدث الابتكارات والميزات المتوفرة على وحدات معالجة الرسومات AMD. من خلال التعاون بين فريق Hugging Face ومهندسي AMD وأعضاء مجتمع المصادر المفتوحة، يسعدنا أن نعلن عن دعم ما يلي:
نحن متحمسون للغاية لجعل أدوات التسريع الحديثة هذه متاحة وسهلة الاستخدام لمستخدمي Hugging Face، ونقدم الدعم والأداء المستمر من خلال التكامل المباشر في خط أنابيب التكامل والتطوير المستمر الجديد الخاص بنا لوحدات معالجة الرسوميات AMD Instinct.
تحتوي وحدة معالجة الرسوميات AMD Instinct MI250 المزودة بذاكرة ذات نطاق ترددي عالي سعة 128 جيجابايت على جهازين ROCm متميزين (وحدة معالجة الرسومات 0 و1)، يحتوي كل منهما على ذاكرة ذات نطاق ترددي عالي سعة 64 جيجابايت.
وهذا يعني أنه باستخدام بطاقة GPU MI250 واحدة فقط، لدينا جهازين PyTorch يمكن استخدامهما بسهولة شديدة مع الموتر وتوازي البيانات لتحقيق إنتاجية أعلى وزمن وصول أقل.
في بقية منشور المدونة، نورد نتائج الأداء للخطوتين المتضمنتين أثناء إنشاء النص من خلال نماذج اللغة الكبيرة:
- زمن الاستجابة للملء المسبق: الوقت الذي يستغرقه النموذج لحساب تمثيل الإدخال أو الموجه المقدم من المستخدم (يُشار إليه أيضًا باسم “وقت الوصول إلى الرمز المميز الأول”).
- فك التشفير لكل رمز الكمون: الوقت المستغرق لإنشاء كل رمز مميز جديد بطريقة الانحدار التلقائي بعد خطوة التعبئة المسبقة.
- فك التشفير الإنتاجية: عدد الرموز المميزة التي تم إنشاؤها في الثانية أثناء مرحلة فك التشفير.
استخدام optimum-benchmark وتشغيل معايير الاستدلال على MI250 وA100 GPU مع وبدون تحسينات، نحصل على النتائج التالية:
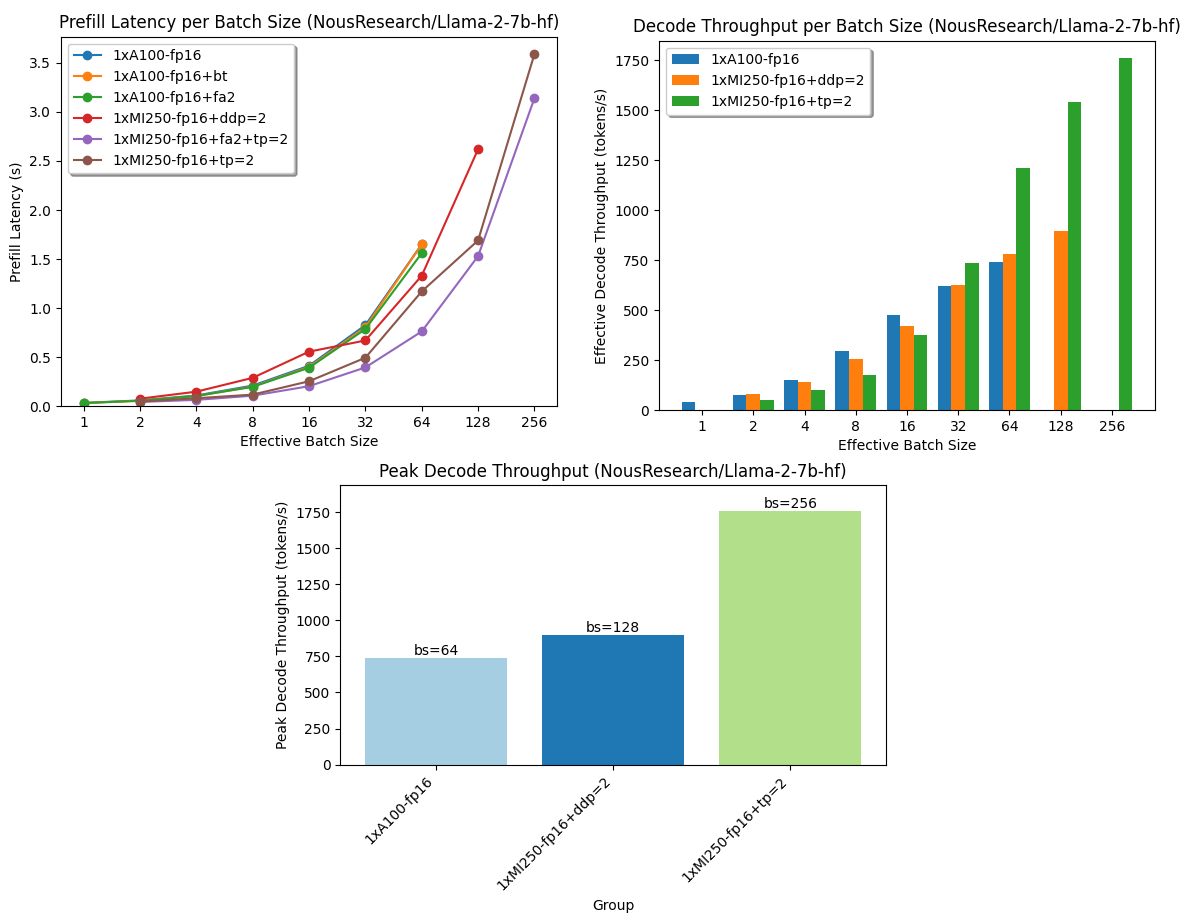
في المخططات أعلاه، يمكننا أن نرى مدى أداء MI250، خاصة بالنسبة لإعدادات الإنتاج حيث تتم معالجة الطلبات على دفعات كبيرة، مما يوفر أكثر من 2.33 مرة من الرموز المميزة (إنتاجية فك التشفير) ويستغرق نصف الوقت للرمز المميز الأول (زمن الاستجابة للملء المسبق)، مقارنة ببطاقة A100.
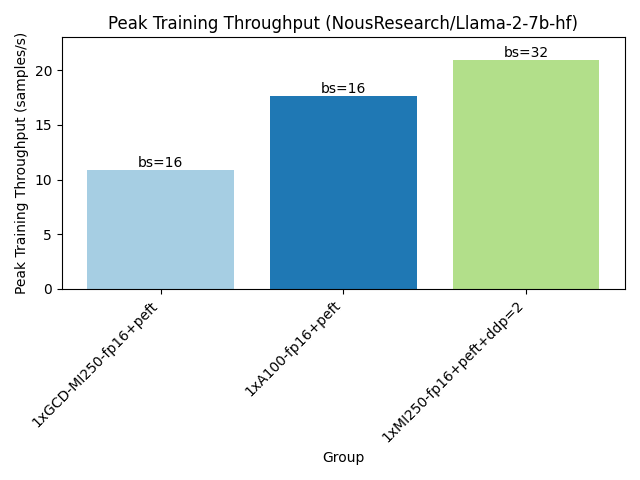
عند تشغيل معايير التدريب كما هو موضح أدناه، فإن بطاقة MI250 واحدة تناسب مجموعات أكبر من عينات التدريب وتصل إلى إنتاجية تدريب أعلى.
حلول الإنتاج
هناك تركيز مهم آخر لتعاوننا وهو بناء الدعم لحلول إنتاج Hugging Face، بدءًا من استدلال إنشاء النص (TGI). توفر TGI حلاً شاملاً لنشر نماذج لغوية كبيرة للاستدلال على نطاق واسع.
في البداية، كان TGI موجهًا في الغالب نحو وحدات معالجة الرسومات Nvidia، مع الاستفادة من معظم التحسينات الحديثة التي تم إجراؤها لبنية ما بعد Ampere، مثل Flash Attention v1 وv2، وتكميم الوزن GPTQ، وPaged Attention.
اليوم، يسعدنا أن نعلن عن الدعم الأولي لوحدات معالجة الرسوميات AMD Instinct MI210 وMI250 في TGI، مع الاستفادة من جميع الأعمال الرائعة مفتوحة المصدر المفصلة أعلاه، والمتكاملة في حل كامل وشامل، وجاهز للنشر.
من ناحية الأداء، فقد أمضينا الكثير من الوقت في قياس استدلال إنشاء النص على وحدات معالجة الرسوميات AMD Instinct للتحقق من صحة واكتشاف المكان الذي يجب أن نركز فيه على التحسينات. على هذا النحو، وبدعم من مهندسي وحدات معالجة الرسومات AMD، تمكنا من تحقيق أداء مطابق مقارنة بما كانت TGI تقدمه بالفعل.
في هذا السياق، ومع العلاقة طويلة الأمد التي نبنيها بين AMD وHugging Face، قمنا بالدمج والاختبار باستخدام أداة AMD GeMM Tuner التي تسمح لنا بضبط نواة GeMM (ضرب المصفوفة) التي نستخدمها في TGI للعثور على أفضل إعداد نحو زيادة الأداء. ومن المتوقع أن يتم إصدار أداة GeMM Tuner كجزء من PyTorch في إصدار قادم ليستفيد منها الجميع.
مع كل ما سبق، يسعدنا أن نعرض أرقام الأداء الأولى التي توضح أحدث تقنيات AMD، مما يضع استدلال إنشاء النص على وحدات معالجة الرسومات AMD في طليعة حلول الاستدلال الفعالة مع عائلة نماذج Llama.
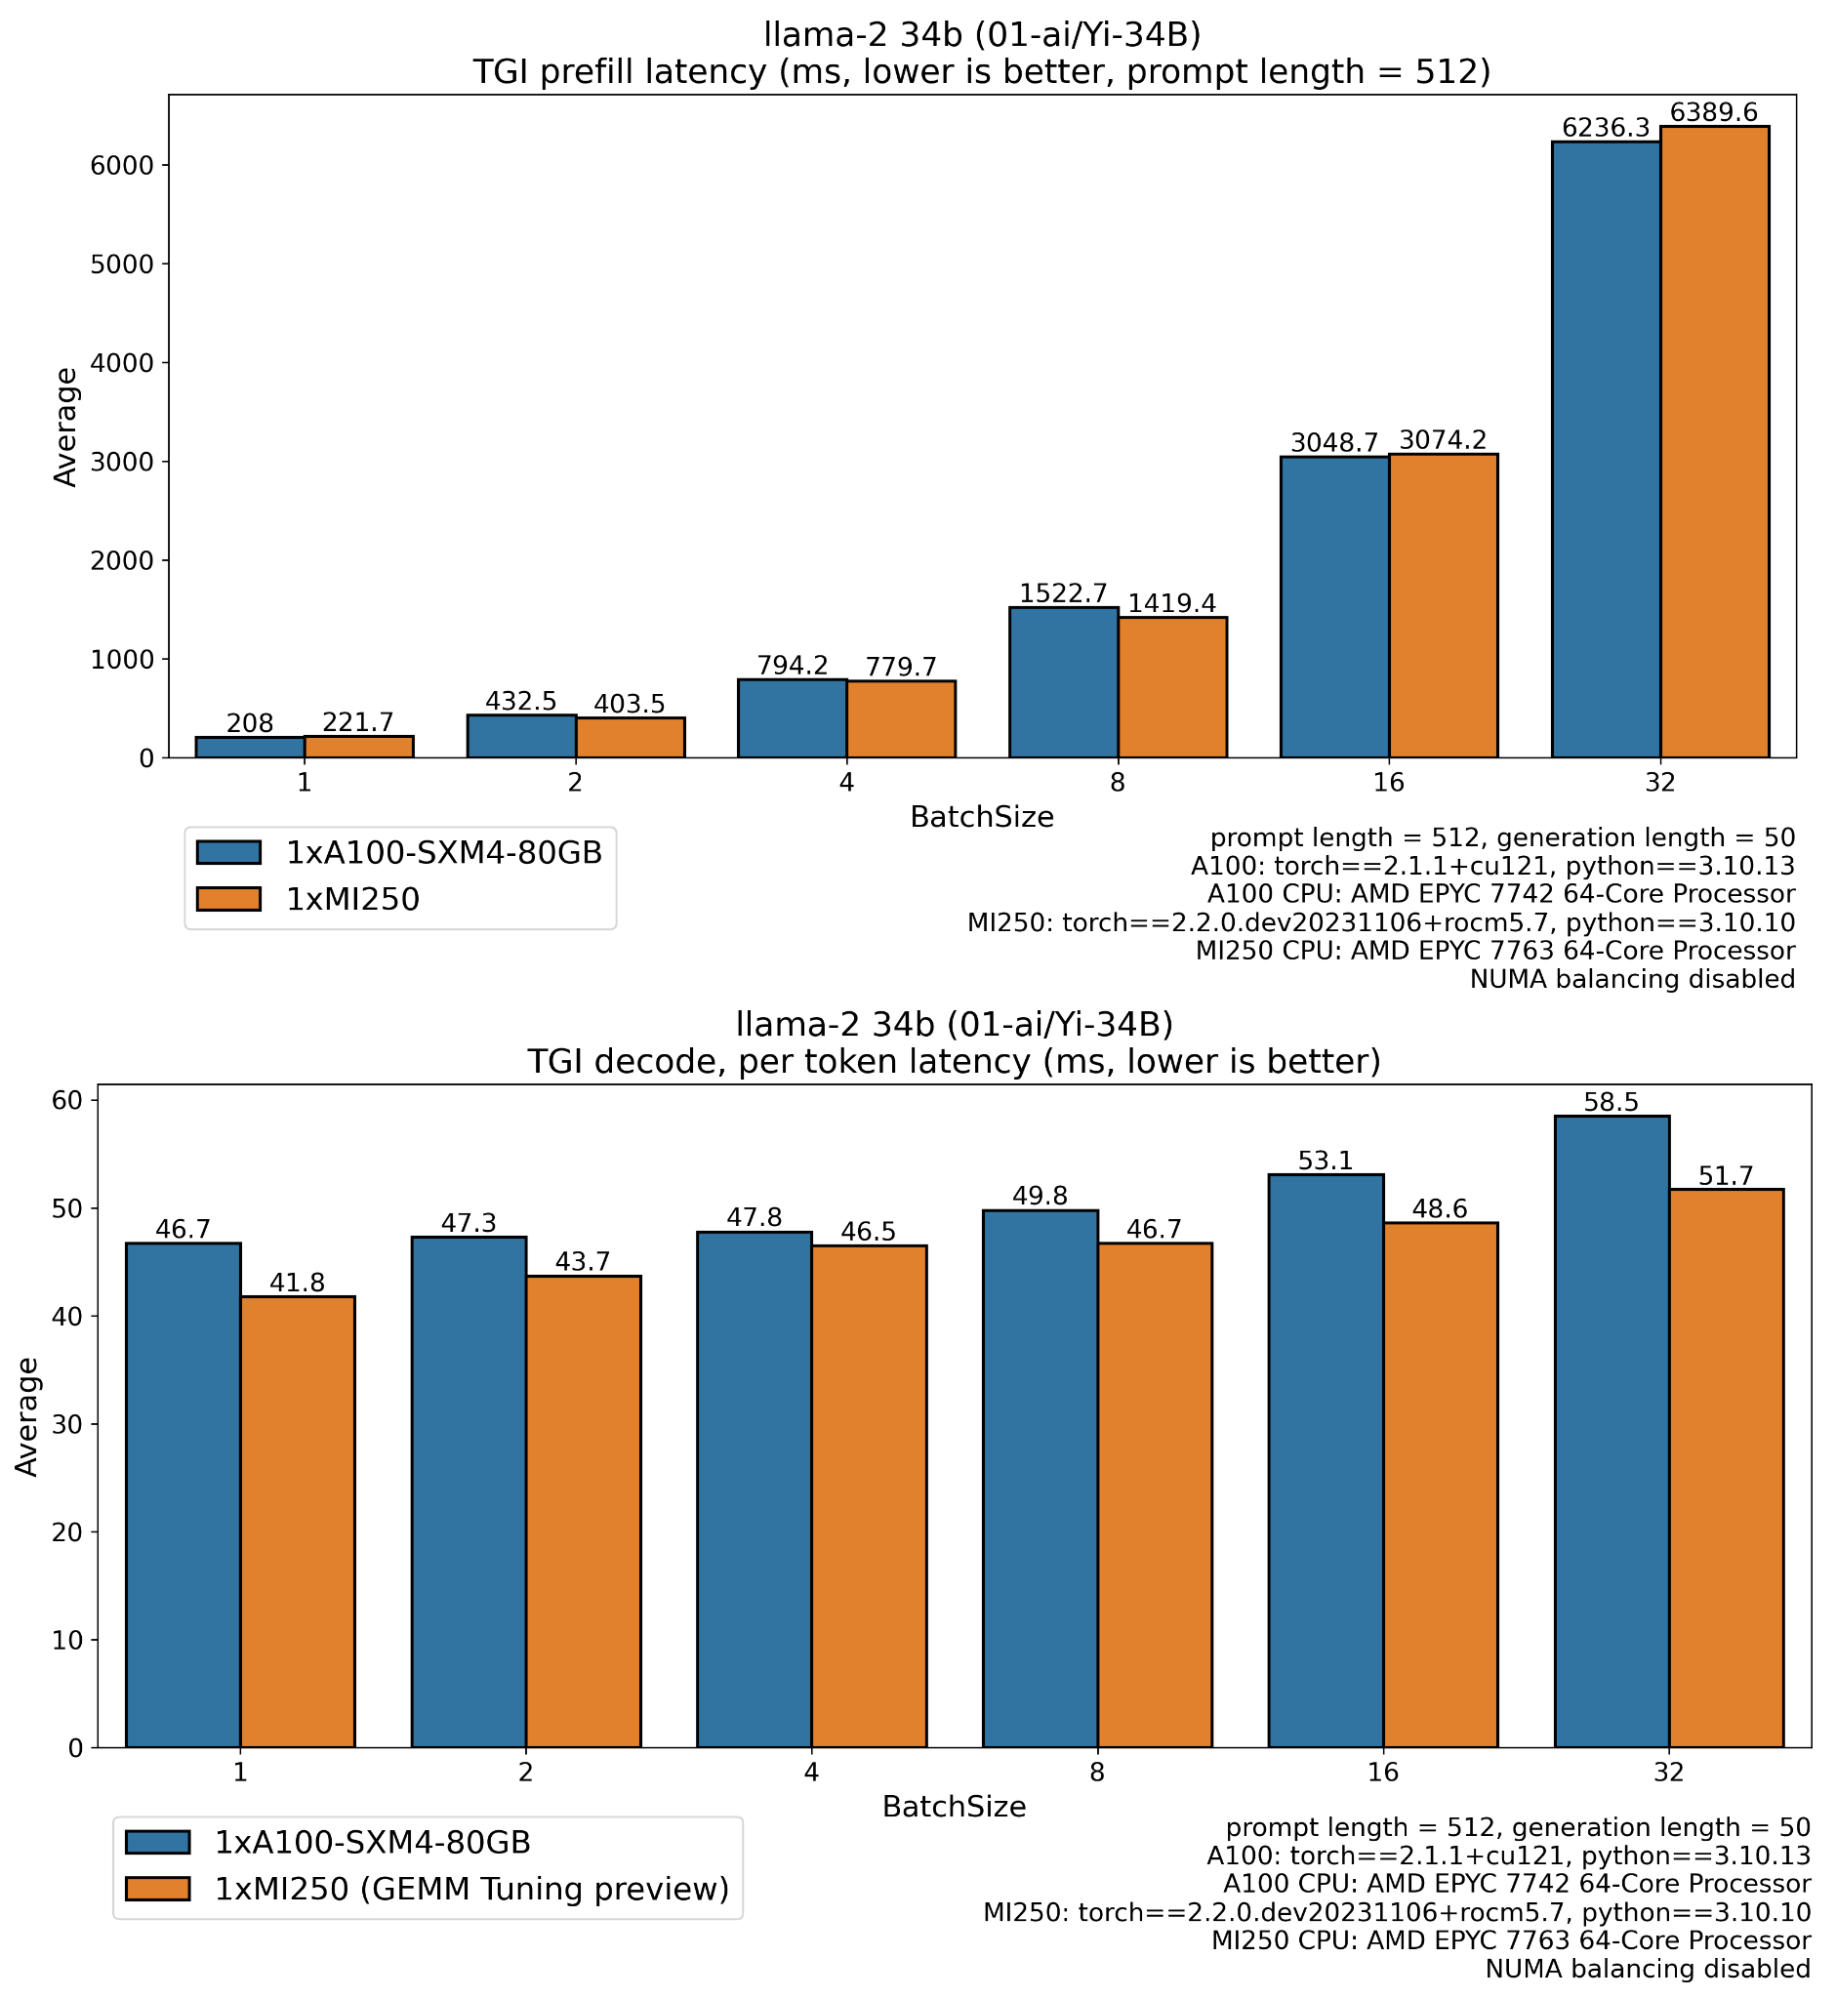
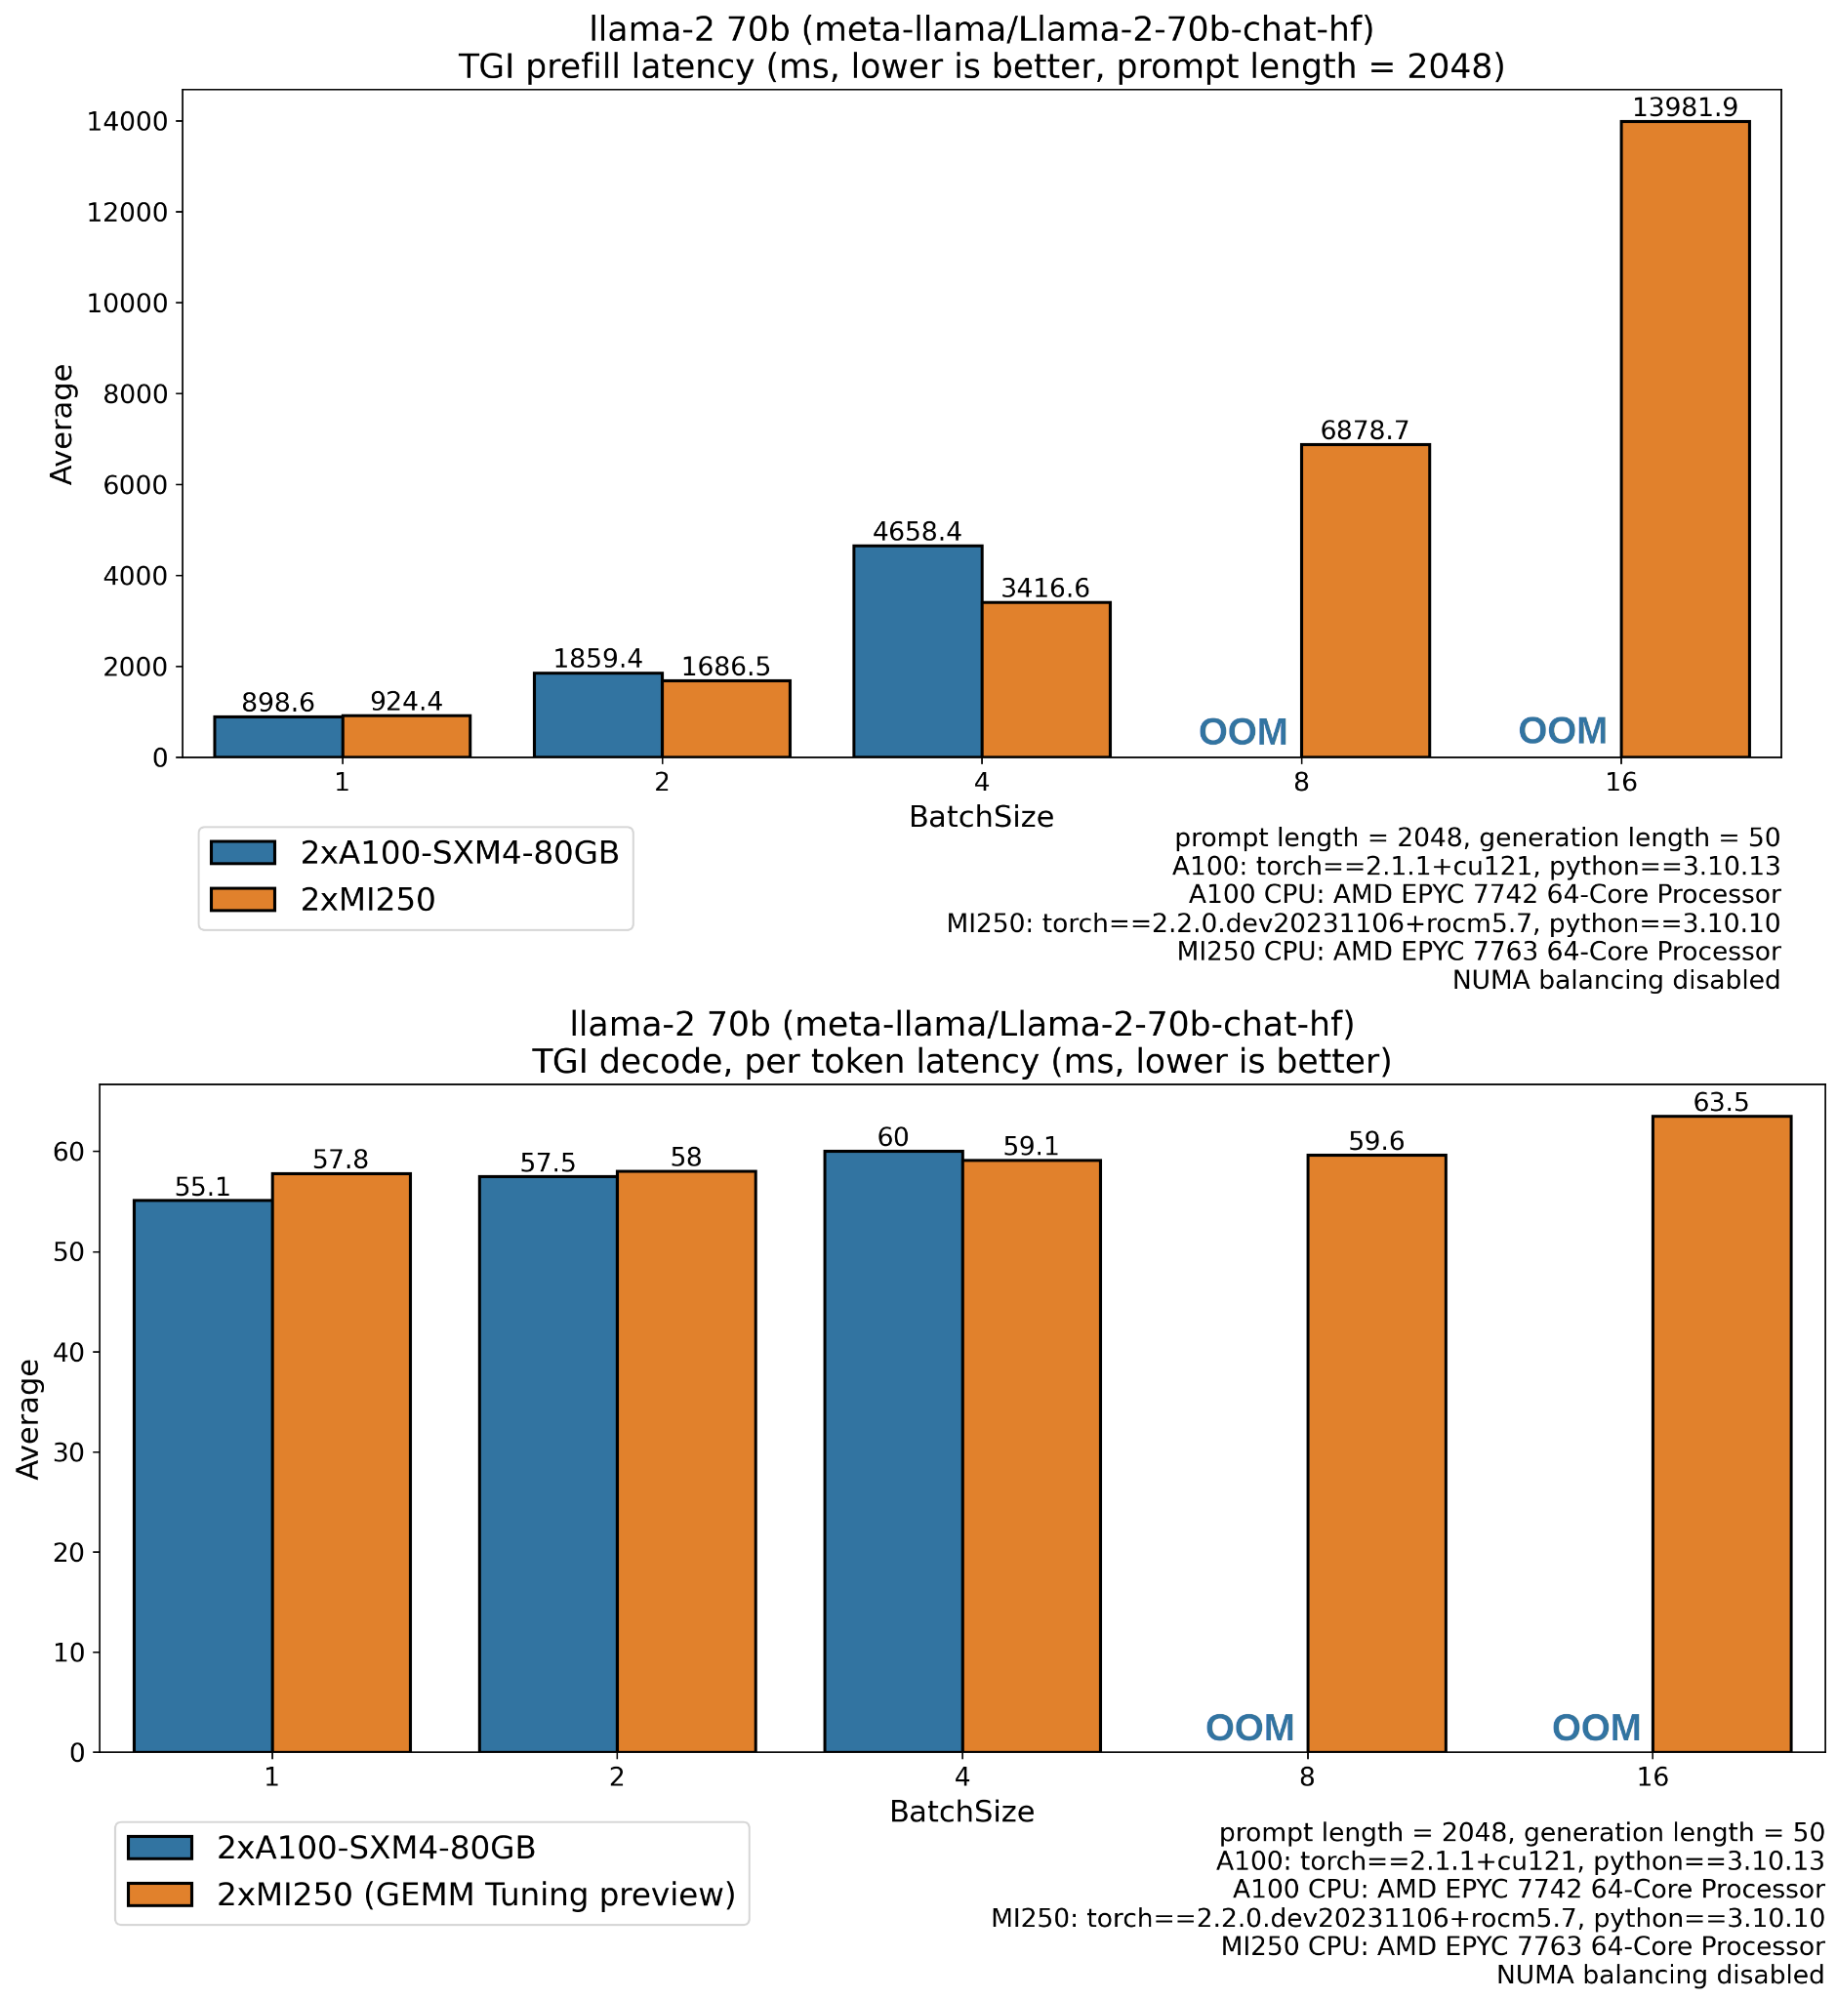
تتوافق الأشرطة المفقودة لـ A100 مع أخطاء نفاد الذاكرة، حيث يزن Llama 70B 138 جيجابايت في float16، كما أن الذاكرة الحرة الكافية ضرورية لعمليات التنشيط المتوسطة، والمخزن المؤقت لذاكرة التخزين المؤقت KV (> 5 جيجابايت لطول تسلسل 2048، وحجم الدفعة 8)، وسياق CUDA، وما إلى ذلك. تحتوي وحدة معالجة الرسوميات Instinct MI250 على ذاكرة عامة تبلغ 128 جيجابايت بينما يحتوي A100 على 80 جيجابايت مما يفسر القدرة على تشغيل أعباء عمل أكبر (أطول) تسلسلات، دفعات أكبر) على MI250.
استدلال إنشاء النص جاهز للنشر في الإنتاج على وحدات معالجة الرسوميات AMD Instinct من خلال صورة عامل الإرساء ghcr.io/huggingface/text-generation-inference:1.2-rocm. تأكد من الرجوع إلى الوثائق المتعلقة بالدعم وقيوده.
ما هي الخطوة التالية؟
نأمل أن يكون منشور المدونة هذا قد أثار حماسك كما نحن في Hugging Face بشأن هذه الشراكة مع AMD. بالطبع، هذه مجرد بداية رحلتنا، ونحن نتطلع إلى تمكين المزيد من حالات الاستخدام على المزيد من أجهزة AMD.
في الأشهر المقبلة، سنعمل على تقديم المزيد من الدعم والتحقق من وحدات معالجة الرسومات AMD Radeon، وهي نفس وحدات معالجة الرسومات التي يمكنك وضعها في سطح المكتب الخاص بك للاستخدام المحلي، مما يقلل من حاجز إمكانية الوصول ويمهد الطريق لمزيد من التنوع لمستخدمينا.
بالطبع سنعمل قريبًا على تحسين الأداء لمجموعة MI300، مما يضمن أن كلاً من المصدر المفتوح والحلول توفر أحدث الابتكارات بأعلى مستوى من الاستقرار الذي نبحث عنه دائمًا في Hugging Face.
سيكون مجال التركيز الآخر بالنسبة لنا هو تقنية AMD Ryzen AI، التي تعمل على تشغيل أحدث جيل من وحدات المعالجة المركزية للكمبيوتر المحمول AMD، مما يسمح بتشغيل الذكاء الاصطناعي على الحافة على الجهاز. في الوقت الذي أصبحت فيه أدوات Coding Assistant وأدوات إنشاء الصور والمساعد الشخصي متاحة على نطاق واسع، من المهم تقديم حلول يمكنها تلبية احتياجات الخصوصية للاستفادة من هذه الأدوات القوية. في هذا السياق، يتم بالفعل توفير النماذج المتوافقة مع Ryzen AI على Hugging Face Hub ونحن نعمل بشكل وثيق مع AMD لتوفير المزيد منها في الأشهر المقبلة.
